

dumpsys meminfo 显示进程内存上涨,Java heap dump 却没有对应的对象增长时,下一步先查上涨落在 Native Heap、图形 Buffer,还是其他映射。若可疑部分来自 malloc/new,heapprofd 可以把分配与调用栈对应起来。
heapprofd 的分配、释放和调用栈记录能与业务事件放在同一条 Perfetto 时间轴上,便于核对一次操作前后哪些分配仍未释放。
heapprofd 是采样工具,看到的 native allocation 不能直接当作 RSS,也不覆盖 Java 对象引用或所有图形 backing 内存。先分清内存账,再决定是否抓 profile。我更倾向先用 meminfo 和 smaps 把上涨来源拆开,再打开 flamegraph;若涨的是 GraphicBuffer,盯着 malloc 调用栈改代码就找错了方向。
版本说明(2026-10 核查):配置、脚本、SQL 与新版 UI 以 Perfetto v58.3 为基线。heapprofd 原生分配分析从 Android 10 提供;本文含自定义 heap 的示例以 Android 12+ 为范围。旧版 diamond 读图方式已在 UI 一节标明,新版时间片的区间结果不能直接当成进程当前总保留量。设备 producer、采集脚本和 Trace Processor/UI 要分别记录版本。
Perfetto 系列文章
- Android Perfetto 系列目录
- Android Perfetto 系列 1:Perfetto 工具简介
- Android Perfetto 系列 2:Perfetto Trace 抓取
- Android Perfetto 系列 3:熟悉 Perfetto View
- Android Perfetto 系列 4:使用命令行在本地打开超大 Trace
- Android Perfetto 系列 5:Android App 基于 Choreographer 的渲染流程
- Android Perfetto 系列 6:为什么是 120Hz?高刷新率的优势与挑战
- Android Perfetto 系列 7:MainThread 和 RenderThread 解读
- Android Perfetto 系列 8:深入理解 Vsync 机制与性能分析
- Android Perfetto 系列 9:CPU 信息解读
- Android Perfetto 系列 10:Binder 调度与锁竞争
- Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测
- Android Perfetto 系列 12:Trace 数据流与丢失排查
- Android Perfetto 系列 13:Perfetto SDK、Track Event 与 App 现场 Trace
- Android Perfetto 系列 14:heapprofd 与内存 Profiling
- Android Perfetto 系列 15:Boot Trace、长时间现场 Trace 与偶发问题抓取
- Android Perfetto 系列 16:GPU、Power Counters 与硬件瓶颈分析
- Android Perfetto 系列 17:专项场景自动化、问题清单与平台体系
- Android Perfetto 系列 18:响应速度实战,从输入事件到首帧反馈
- 视频(B站) - Android Perfetto 基础和案例分享
- 视频(B站) - Android Perfetto 分享 - 出图类型分享:AOSP、WebView、Flutter + OEM 系统优化分享
内存问题要分几张账
开始抓 heapprofd 前,先把内存数据分成几类。很多误判都来自把它们混在一起。
| 数据 | 常见来源 | 回答什么问题 |
|---|---|---|
| 进程 RSS / swap 趋势 | linux.process_stats |
目标进程 RSS、anon/file RSS、swap、oom_score_adj 有没有变化 |
| 进程 PSS / Private Dirty | dumpsys meminfo、/proc/<pid>/smaps_rollup、process_stats_config.scan_smaps_rollup |
PSS、Private Dirty、SwapPss 是否上涨;scan_smaps_rollup 受权限和目标进程限制 |
| 系统内存压力 | linux.sys_stats |
MemAvailable、Cached、ZRAM、vmstat、PSI 是否说明系统在回收或承压 |
| native allocation 调用栈 | android.heapprofd |
哪些 malloc/new 调用栈贡献了分配,哪些还没释放 |
| Java 对象保留关系 | android.java_hprof、MAT、Android Studio Profiler |
哪些 Java 对象还被谁持有 |
heapprofd 默认统计的是目标进程向 libc malloc/free、new/delete 这类 allocator 请求的字节数。它不等于 RSS,也不覆盖所有 native backing。
另一个边界是起点:运行中 attach 不会回溯已经分配的存量。这里“未释放”只涵盖本次 profiling 开始后观察到的采样分配;名称匹配覆盖了进程,也不意味着拥有整个进程生命周期的账本。
GraphicBuffer、dma-buf、GPU texture、驱动侧分配、直接 mmap/memfd/ashmem 或绕过 libc malloc 的 allocator 不在默认 malloc 账里。基于 malloc 的 arena 可能只看到 arena 大块,看不到内部对象。自研 allocator 想进这张账,可以用 heapprofd 的 custom allocator API(AHeapProfile_registerHeap 等,需要链接 client 库并改分配路径),再在 heapprofd_config.heaps 里点名自定义 heap;这属于专项投入,不是默认能力。图形内存要先看 meminfo Graphics/GL、dmabuf、GPU/graphics 计数、SurfaceFlinger / BufferQueue 关系。
heapprofd 适合补充 App、HWUI、Skia、JNI 等路径中走 malloc/new 的分配证据。
不同增长来源对应不同工具:
| 现象 | 优先工具 | heapprofd 角色 |
|---|---|---|
| Java heap 上涨,对象保留明显 | HPROF / MAT / Android Studio | 不作为第一入口 |
| Native Heap / malloc wrapper 上涨 | heapprofd | 找 malloc/new 调用栈 |
| Graphics / GL / dmabuf / Surface buffer 上涨 | meminfo、dmabuf、GPU/graphics、SurfaceFlinger | 只用于排除 App/native wrapper 是否也在分配 |
| RSS/PSS 上涨但 heapprofd 不高 | smaps_rollup、maps、mmap/syscall、dmabuf/graphics | 先拆账,不要直接判 heapprofd 抓错 |
| PSS 不涨但 RSS 涨 | smaps / file mapping / allocator cache | 先不要下泄漏结论 |
allocator 线程缓存、碎片、ZRAM、page 粒度都会让 RSS 和 heapprofd 对不上。看到 RSS 高而 heapprofd 不高时,要先考虑这些边界,不要立刻判成 heapprofd 抓错了。
反过来也一样:heapprofd 里某条调用栈累计分配很高,不代表进程 RSS 会同幅度上涨。它可能是分配 churn:频繁申请、很快释放,Total malloc size 高,但 Unreleased malloc size 不高。内存问题要先分清“占住不放”和“反复制造临时对象”。
怀疑 mmap 等账外分配时,先查 smaps 的 Private_Dirty/Rss/Pss 与 maps。Perfetto 的 raw_syscalls 采集依赖内核事件和权限,Android 官方支持范围是 userdebug,不能写成“Android 14+ 普遍可用”;sys_mmap 等 slice 通常只反映调用与耗时,不带地址、长度参数,不能直接恢复 mmap 字节账。perf/simpleperf 的 syscall 栈还需单独满足事件与采样权限。
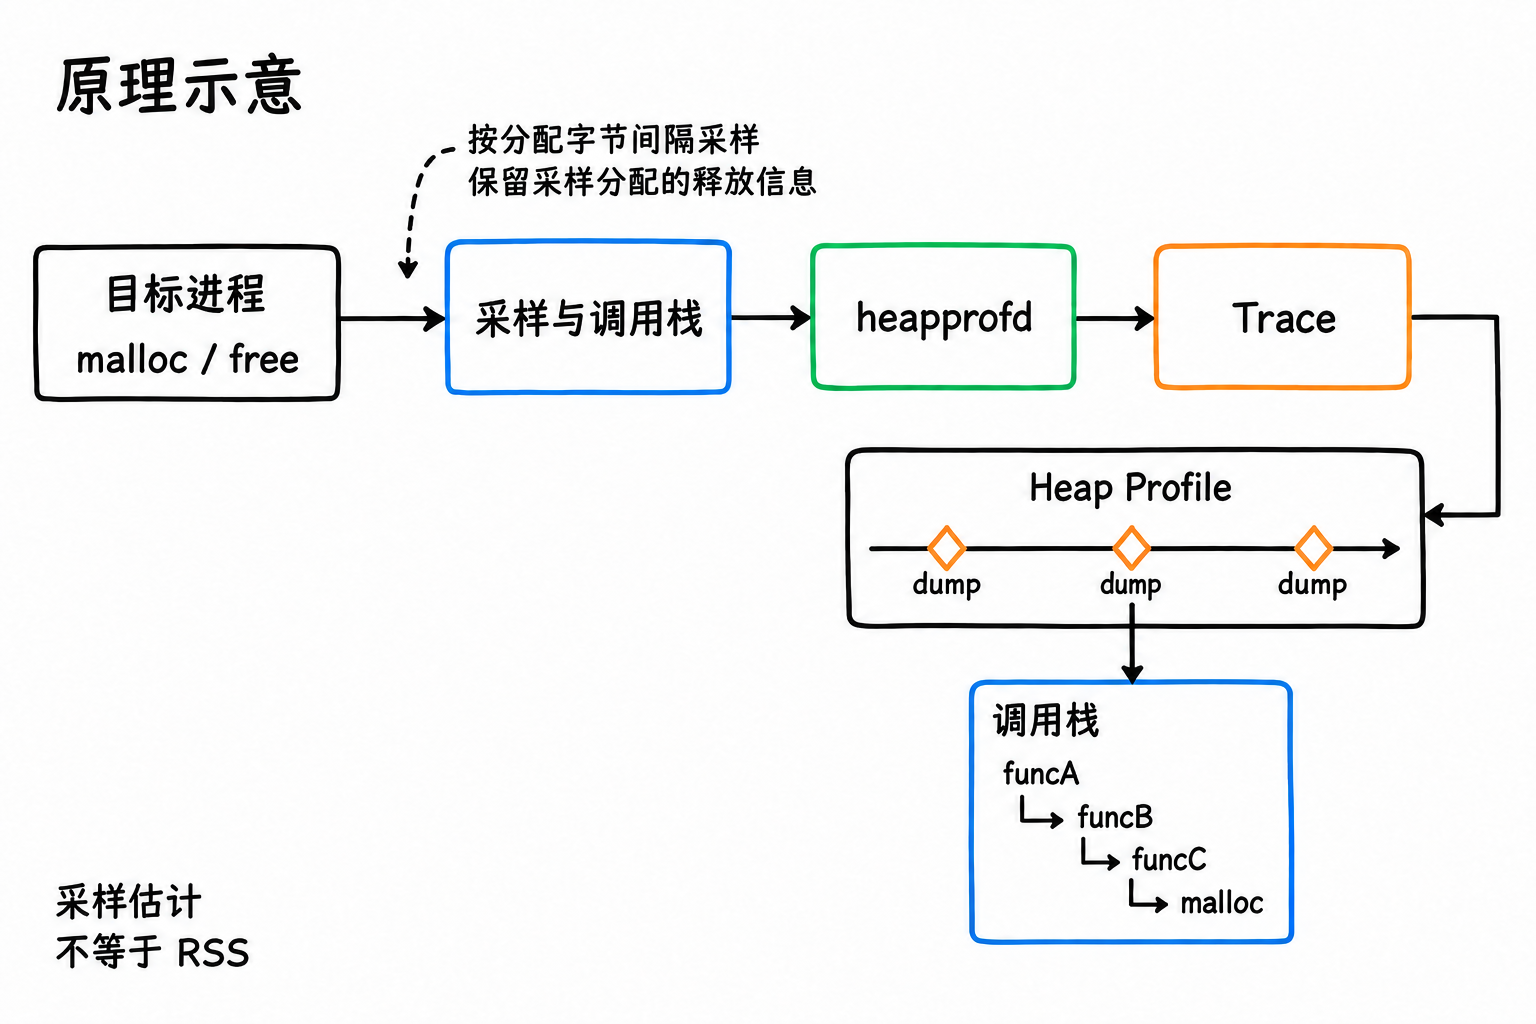
原理示意:heapprofd 采样 native 分配并记录调用栈;Heap Profile 不是 RSS 账本。
图中“采样与调用栈”概括了两个环节:目标进程采样后复制原始栈与寄存器,经共享内存交给 heapprofd 异步 unwind、记账,再写入 Trace。它不是在每次 malloc 时同步完成全部符号化。
什么时候用 heapprofd
Java heap dump 看不到增长来源时,先看增长落在哪张账。只有 native heap 或 native wrapper 明显可疑时,再进入 heapprofd。
heapprofd 适合这些问题:
- Native Heap / malloc wrapper 持续上涨,但 Java heap dump 看不出明显对象保留。
- Bitmap、Skia、播放器 buffer、JNI/C++ 模块怀疑有 libc malloc/new 路径上的 native backing 占用。
- C++ 模块、native service、daemon 的 malloc/new 异常。
- 想知道某次业务操作后未释放分配是否增加。
- 想把内存增长和线程运行、Binder、业务 Track Event 关联起来。
这些问题不该优先用 heapprofd:
- 只想看 Java 对象引用关系。用 Java heap dump。
- 想把每一次小分配都精确记成账本。heapprofd 默认是采样 profiler。
- 目标 App 在 user build 上没有
debuggable或profileable。这类进程通常不能被 shell profile。 - GraphicBuffer、dma-buf、GPU driver memory、Surface buffer 数量上涨。先走 meminfo Graphics/GL、dmabuf、GPU/graphics、SurfaceFlinger 的证据链,heapprofd 只用来排除或定位 malloc/new 包装层。
目标资格也要分开看。user build 主要面向 debuggable/profileable Java apps;userdebug/eng 可抓大多数 App 和 system services,但少量 critical services 可能被 SELinux never_profile_heap 之类策略禁止。system process 不靠 <profileable> 解锁。
快速抓一份 native heap profile
官方建议先用 tools/heap_profile。下面从 Perfetto v58.3 源码根目录运行,需主机 Python 3、adb 与已授权设备;工具文件不是 Android 系统自带命令。脚本可能按自身清单下载主机转换工具,保存脚本版本及实际工具版本,不能把它们都按设备 Android 版本记录。
这条命令按进程名抓 15 秒,采样间隔 4096 bytes,每 5 秒产生一个 continuous dump:
1 | out_dir=$(mktemp -d /tmp/heapprofd-com-example-app.XXXXXX) |
脚本要求 -o 指向已存在且为空的目录;上面的 mktemp -d 为本次抓取创建独立空目录。输出目录里会有 raw-trace 和转换后的 profile 文件。把 raw-trace 拖到 Perfetto UI,在目标有成功 profile 时可看到对应 Heap Profile 轨道。
-n com.example.app 匹配已运行的目标,也等待后续同名进程启动;PID 方式只针对指定的运行中实例。多进程要写 -n com.example.app,com.example.app:remote,com.example.app:player:v58.3 的脚本接收逗号分隔列表,重复写多个 -n 会覆盖前值。手写配置则重复 process_cmdline 字段。每个目标仍需满足权限;启动抓取也可能漏掉 zygote specialize 最早的分配。v57+ 的 cmdline 通配符仅支持已运行进程且要求 no_startup=true,不能拿 com.example.app* 代替启动期多进程名单。
如果要在 user build 上用 adb / shell 抓 App,需要 manifest 里允许 shell profiling:
1 | <application ...> |
这条路径只解决本地 shell profiling 权限,不等于线上可以远程抓任意用户进程。
Android 15(API 35)起,App 可通过 ProfilingManager 请求 heap profile,需配置 executor/listener,并处理延迟启动、限流和失败。触发器注册从 API 36 提供;Android 17 / API 37 的 OOM 触发器 返回 Java heap dump,并非 malloc profile,且自定义 UncaughtExceptionHandler 必须继续调用默认处理器。ANOMALY 的产物按异常类型变化。触发结果通过全局 listener 交付,受系统策略限制;线上请求路径与 adb/shell 的实验室路径分开设计。
和系统 Trace 合在一起抓
脚本适合快速定位,手写 TraceConfig 适合把 heapprofd 和系统数据源合并。先看最小 heapprofd 配置:android.heapprofd、process_cmdline、采样间隔、continuous dump、shared memory 和阻塞策略。
系统上下文是增强项:本例 process_stats 默认轮询 RSS/swap,不会自动得到 PSS;scan_smaps_rollup 在 Android 上通常要求 root 的 traced_probes/tracebox,不能只靠 profileable 解锁。sys_stats 这里只开了 meminfo/vmstat,没有配置 psi_period_ms。ftrace 和 track_event 用于对齐业务窗口,实际 producer_name_filter 要按查询到的名称填写。合抓会增加扰动,需对照无 profiler 的场景耗时。
1 | duration_ms: 15000 |
这仍然是 native heap 模板,不是图形内存模板。排查 GraphicBuffer、dma-buf、GPU texture、Surface buffer 时,要额外对照 dmabuf、GPU/graphics 计数、dumpsys meminfo Graphics/GL、SurfaceFlinger layer / buffer 信息;heapprofd 只能回答 malloc/new 侧有没有对应贡献。
本例 central buffer 合计 80 MiB,低于启用 extra guardrails 时默认的 128 MiB 总上限;原 160 MiB 配置可能被拒绝。容量仍需按 dump 峰值实测。heapprofd 的 DISCARD buffer 满后会丢弃新数据,末尾 dump 可能不全。Ring Buffer 可能覆盖历史 profile packet、interned 调用栈或统计,不是无条件替代方案;先减目标/时长/采样密度,再评估预算和写文件策略。
临时排查时,直接把 PBTX 通过 stdin 传给 perfetto 最稳。输出路径在 Android 上放到 /data/misc/perfetto-traces/:
1 | adb push config.pbtx /data/local/tmp/config.pbtx |
手写 HeapprofdConfig 默认 block_client=false,而脚本默认开启阻塞。前面的快速命令显式加 --no-block-client:共享内存耗尽时 profile 可能提前停止,而不是只丢几个样本后照常继续。8 MiB 的 shmem_size_bytes 是目标进程与 heapprofd 之间的缓冲,不是上面的 central buffer。
实验室 leak 复现可评估 block_client=true 与 block_client_timeout_us,但这是用目标 malloc 路径的阻塞换取采集机会,不保证无损。v58.3 要求超时大于 100 μs 才会重试,达到超时仍会停止;旧 Android 10/11 还有小共享缓冲与阻塞导致卡住的已知问题。交互场景先保持非阻塞,核对 overrun、non-finalized、真实 dump 时间和窗口;max_heapprofd_memory_kb/max_heapprofd_cpu_secs 限制的是 profiler 自身内存/CPU 时间,不能当目标 App 内存限制或 wall-clock 时长。
把 heapprofd 放进系统 Trace 时,建议同时保留少量业务 marker。App 内用 android.os.Trace / AndroidX Trace 会落到 atrace;Perfetto SDK Track Event 需要单独启用 track_event data source。
比如播放器场景至少要有 operation_start、steady_state、operation_end、release_done/gc_idle_done 四类 marker。没有 release marker 时,结论只能写“操作后保留增加”,不能写“泄漏”。官方文档将 android.log 支持范围写为 userdebug;已 root 且 logd/SELinux 权限允许的 user 构建也可能采到,但不能仅凭 adb root 推广到所有设备。普通生产 user build 上不要把 logcat 当成这份配置默认能抓到的证据。
UI 怎么看 Heap Profile
旧版 UI 常把 Heap Profile dump 画成 diamond;本文两张图沿用这种示意,并非当前界面截图。Perfetto v58.3 已用时间片展示目标进程/heap 的 profiling interval,点击时间片打开 flamegraph;框选多个连续片段可汇总所选窗口。先确认选中的进程、heap 和时间范围。
v58.3 选中单个时间片得到的是区间指标,并非自动从 profiling 开始累计到片尾。UI 对所选区间的 callsite 净计数做过滤,会隐藏某些“释放了窗口前分配”的负贡献;因此 Unreleased 不能直接当成该时点的全部保留量。要比较操作前后保留状态,使用后文按 upid/heap 累加至 dump_ts 的 SQL,并先核对历史完整性。读图时按这个顺序走:
- 先区分当前区间的 Unreleased 与从 profiling 起点累计的保留量,不直接相减不同区间的 UI 数值。
- 看
Total malloc size,判断是不是分配 churn 很高但释放也快。 - 用火焰图宽度与 self/cumulative 指标找贡献较大的调用路径,界面选项名以当前版本为准。
- 先找 allocator / ART glue 之上的第一个 App、SDK 或业务帧。
- 回到时间轴,关联触发操作、业务 Track Event、线程运行。
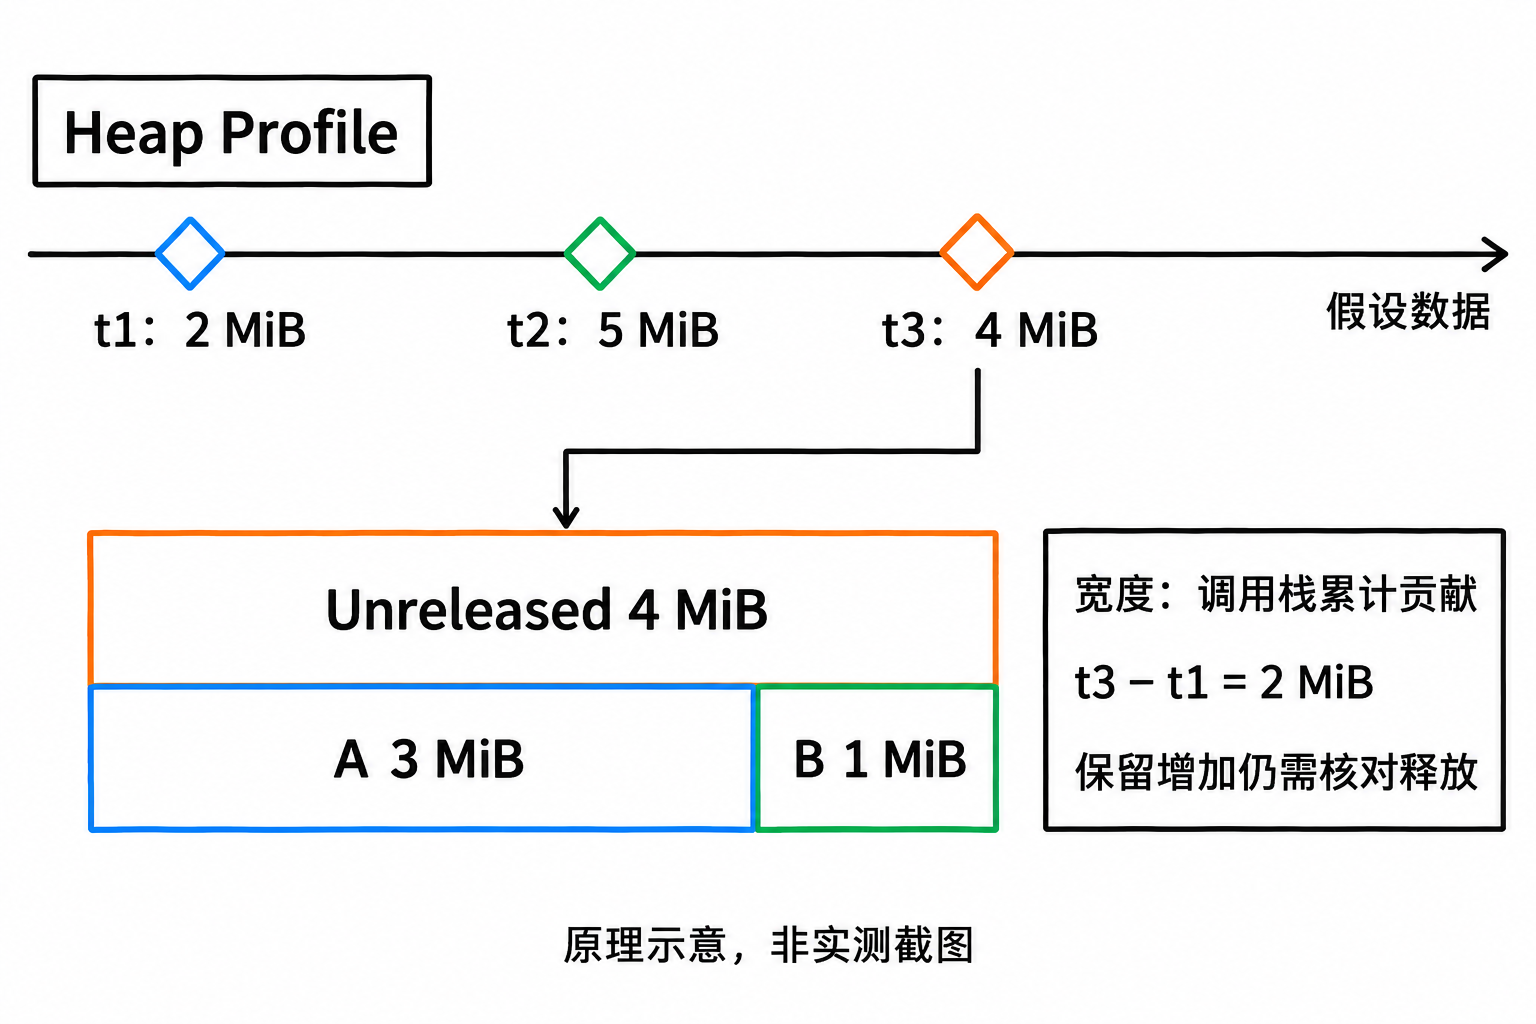
历史 diamond 样式的假设示意:2→5→4 MiB 表示按同一起点累计至三个 dump 的保留估计,不是 v58.3 三个独立区间的默认 UI 数值;单点不能判泄漏。
不要用单个 profile 点或时间片判泄漏。泄漏判断至少要看“操作前、操作后、回收后”几个点。如果操作后上涨,回收后仍然不降,再看未释放调用栈。
实验室可在权限允许时用 adb shell killall -USR1 heapprofd 请求额外 snapshot;它影响该 daemon 当前 profiling 的所有进程,不是仅当前 App。比如进入页面前、页面稳定后、退出页面并完成 release/close/析构后,各请求一次。请求与实际 dump 之间有延迟,按 heap_profile.ts_end 核对时间。baseline 选操作前已完成的 dump,after-release 选 cleanup marker 之后的 dump,不能只取最近点而落到动作另一侧。
只有当 native backing 由 Java wrapper、NativeAllocationRegistry 或 Cleaner/finalizer 持有时,才需要把“等待 idle、finalizer、GC 完成”算进这个状态点。allocator cache 和碎片还可能导致 heapprofd 数字下降了、RSS 却不立刻下降。缓存不是“不释放”的委婉说法,必须有容量上限、命中/复用证据、退出或压力下回收策略;否则只能写“疑似长期保留”。
SQL 怎么查未释放分配
heapprofd 会写入调用栈相关表:
| 表 | 含义 |
|---|---|
heap_profile_allocation |
allocation/free 的样本和大小 |
stack_profile_callsite |
调用栈节点 |
stack_profile_frame |
函数帧 |
stack_profile_mapping |
so、apk、jar、binary 映射 |
stack_profile_symbol |
离线符号化结果 |
单目标 profile 快速读图时,优先用官方标准库里的 summary tree。它会沿着 stack_profile_callsite.parent_id 聚合整条调用栈,结果更接近 flamegraph 里的 cumulative view:
1 | INCLUDE PERFETTO MODULE android.memory.heap_profile.summary_tree; |
summary tree 汇总整份 Trace 中所有进程、heap 和时间的记录;本例只适合仅采单进程 native heap 时查看末尾累计状态,不是任意选定时点或新区间的快照。它没有进程列,不要直接用于多进程回归统计。多进程 App、:remote 进程或同名进程重启时,要回到原始表按 upid、进程身份和 dump 时间点过滤,避免把别的进程归到目标进程。
按明确进程实例与 dump 结束时间粗查时,先列出 process/heap_profile,再把下列 SQL 的 NULL 替换为确认过的 upid。分配为正、释放为负,SUM(a.size) 累加到选定 ts_end 得到已观察部分的保留估计,和新版 UI 的单区间 Unreleased 口径不同。heap_profile_allocation 是按 dump 写入的增量,ts 是 dump 时间,不是逐次 malloc 的调用时刻。以下只统计 libc.malloc;com.android.art 不记录 free,不能混成未释放 native 内存。
1 | SELECT p.upid, p.pid, p.name, p.cmdline, p.start_ts, |
1 | WITH target_process AS ( |
这条 SQL 保留 callsite_id,只附上该调用栈叶帧的名称;它没有把一条栈展开成多行。未知名称不应删掉对应字节。summary tree 的 cumulative_size 包含子树贡献,父子行会重复覆盖同一批字节,不能把 Top 50 行再求和当总量。最终归因仍需完整调用链和对应 build 的符号。
没有分配变化的 dump 可能没有新 allocation 行,故从 heap_profile.ts_end 选点,不用 MAX(allocation.ts) 冒充最终 dump。heap_profile 行本身没有“全链路已无损完成”的布尔证明;同时检查 profile packet、stats 和时间覆盖。旧 Trace Processor 缺该表时应升级或单独核实,不把缺表/缺数据当零。SQL 也不能凭空补齐没有成功解析的历史。
泄漏候选判断要做操作前、操作后、释放后三点对比。下面要求同一 upid/heap、三个已确认且严格递增的 dump 结束时间;NULL 都是待填项,不能直接当作报告结果。只有三个点均存在才返回对比行:
1 | WITH target_process AS ( |
三个 dump 存在仍不等于完整性通过。先验收采样会话、开始时刻、丢失与调用栈状态;无返回行需区分参数未填、缺 dump、无有效 callsite,不能宣布“全部已释放”。只有在合格的同一次采集中,某栈在早期尚未出现时,pivot 中的 0 才是该观察范围的零贡献。1 MiB 只是示例筛选阈值,不是统计显著性标准。
释放后持续保留且多轮复现,才值得追查泄漏候选;操作中升高后回落只是已观测点之间的暂时增长,不证明期间最大峰值。before/after 差值也是净变化,期间新分配会抵消释放,不能把差值叫作实际释放总量。缓存仍需容量、复用与回收证据。
报告字段可以固定成这一组:
以下是假设记录,不是上面 SQL 的直接输出;符号、采样数、loss 和证据等级需分别计算或核对。字节除以 1024² 的列统一用 MiB / _mib。
1 | trace_name,process_name,upid,pid,scenario,dump_phase,dump_ts_ms,sampling_interval_bytes,dump_interval_ms,top_stack_frame,mapping_name,unreleased_mib,retained_delta_mib,total_malloc_mib,sampled_allocation_count,symbol_status,profileable_state,data_loss_status,evidence_grade,conclusion_type,next_action |
采样间隔怎么理解
sampling_interval_bytes: 4096 表示按分配字节做随机采样,不是每隔固定时间采一次。v58.3 的 Sampler::SampleSize 对大于等于当前采样间隔的分配返回真实请求大小;更小的分配按抽样权重估计。这个实现分支并不让整份 profile 变成精确账本:采样起点、丢失、unwind 和动态调整后的实际间隔仍会影响结果。
怎么选:
- 4096 bytes 是常用起点,适合大多数本地分析。
- 怀疑大量小对象 native 分配时,可以降低间隔,但开销会上升。
- 分配速率太高导致 buffer overrun 时,先增大 shared memory 或提高采样间隔。
- 手写 HeapprofdConfig 要为每个目标 heap 配置非零间隔;设 1 会观察全部非零分配,开销很高且仍可能丢失。0 不是关闭采样,旧 Android 10/11 甚至可能导致目标崩溃。
报告里不要把采样结果写成“精确分配了 12.34MB”。更合适的写法是:“在 4096 bytes 采样间隔下,未释放分配主要集中在 A/B/C 三条调用栈,A 调用栈占比最高”。采样 profiler 的价值是找方向和排序,不是替代 allocator 账本。
小对象密集、样本少、窗口短、调用栈分散时,top stack 排名会不稳定。before/after 比较必须保持同一采样间隔、相近负载和同一目标窗口;不要比较 1% 或 2% 这类小差异,除非多次复现。报告里的 evidence_grade 可以按这个规则写:样本充足、连续 dump 趋势一致、符号完整为 strong;命中 data loss、profile incomplete、unknown symbols、样本少或只复现一次为 weak。weak 时写“候选调用栈”,不要写“根因调用栈”。
启用 adaptive_sampling 时,初始 4096 不代表全程都用 4096;还要记录调整统计和实际采样条件。strong 只是本文自定义证据分级,不是 Perfetto 给出的统计置信度。Android 12 与部分 Android 13 ART 版本可能缺 Java unwind,官方标明 Android 13 QPR1 修复相关问题;补 symbols 无法恢复根本未采到的栈帧。
Java heap dump 和 Java allocation sampling
这部分是对开头几张内存账的补充:heapprofd 能看 native malloc/new,也能在 Android 12 或更高版本上切到 Java allocation sampling,但它仍不替代 Java heap dump。
| 能力 | 输出 | 适合问题 |
|---|---|---|
| heapprofd native profiling | malloc/new 调用栈 | 谁分配了 native 内存 |
| Java heap dump | 对象保留图 | 谁持有 Java 对象 |
| Java allocation sampling | Java 创建对象的调用栈 | 哪些代码制造了大量 Java allocation churn |
Java allocation sampling 可以通过 heapprofd 配置 heaps: "com.android.art" 打开,也可以用脚本参数 --heaps com.android.art。它需要 Android 12 或更高版本。它记录对象创建时的调用栈,不记录对象什么时候被 GC,也不等价于 Java heap dump 的保留关系。
android.java_hprof 生成的是 Perfetto ART 引用图,不是可直接交给 MAT 的标准 .hprof;MAT/Android Studio 的 HPROF 流程要另行采集。两者的输出格式和可见字段不同。
符号化和可信度
如果 flamegraph 里都是地址、unknown 或混淆后的 Java/Kotlin 名字,先准备对应构建的 unstripped ELF / Breakpad symbols、R8/ProGuard mapping 和 PATH 中的 llvm-symbolizer,再运行支持 bundle 的 Trace Processor。bundle 将原始 trace 与成功找到的符号信息打包,不会替你生成缺失符号;完成命令后仍要检查符号覆盖和 Build ID。具体选项见 v58.3 符号化文档。
1 | trace_processor bundle \ |
替换路径和包名;没有 Java 混淆帧时可去掉 --proguard-map。把生成归档直接交给支持该格式的 UI/Trace Processor,无需手工拼接;若本机版本没有 bundle,按所用版本文档处理,不能把不存在的子命令当作成功符号化。
报告里要记录 APK/build id、native symbols 版本、ProGuard/R8 mapping 版本;Build ID mismatch 时降级为地址级证据。第三方 SDK 或 stripped so 只剩地址时,下一步是补对应 build 的 unstripped symbols / mapping,而不是直接改业务代码。
读调用栈时也不要盲目过滤 libart.so、allocator glue 或系统库。ART 帧有时正是 Java 调 native、NativeAllocationRegistry 或对象创建路径的关键上下文。
先找 allocator/ART glue 之上的第一个 App、SDK 或业务帧;只有确认某类帧只是重复胶水层时再过滤。看到 DEDUPED、ICF 造成的函数折叠、Build ID mismatch、只有一帧等情况,要先按符号化问题处理。
unwind 可信度也要看:未知帧比例、单帧栈比例、Build ID 是否匹配、Java frame 是否可用、目标 ABI / Android 版本 known issues。缺符号会改变归因可信度;报告里要区分“已符号化可归因”和“只能定位到 so / allocator glue”。
报告里至少要交代清楚:
- 目标进程是否 profileable/debuggable。
sampling_interval_bytes和 continuous dump 间隔。stats里是否出现 heapprofd buffer overrun、client error、profile incomplete、heapprofd_unwind_time_us、heapprofd_client_spinlock_blocked、heapprofd_sampling_interval_adjusted或 data loss。
出现 data loss 或 overrun 时,既不能写精确账本,也不能默认保留下来的栈仍是全程“大头”:丢失可能改变排名。先限定有效窗口,证据不足时只列候选调用栈并补采。
通用的 Trace 体检(buffer/ftrace 丢失)直接用第 12 篇那条 stats 查询;heapprofd 专用 health check 要单独跑。heapprofd_buffer_overran、heapprofd_client_error、heapprofd_hit_guardrail 等在 v57.2/v58.2 已存在,多数属于按需生成记录的 indexed stats;在没有 heap profile 的 Trace 上只查到两个 single 项,不能推断其他项是新版本专属。
先确认目标进程/heap 的 profile 或 dump 确实存在、窗口覆盖且已完成,再解释下面的异常查询。没有 profile 时应标记 profile_unavailable,不是“全部干净”;有 profile 但异常查询为空,也只能说明未记录到这些异常。heapprofd_unwind_time_us、heapprofd_client_spinlock_blocked、heapprofd_sampling_interval_adjusted 是开销/采样上下文,不应与非零 error/data_loss 一律判失败。
heapprofd_last_profile_timestamp 是辅助的最后 profile packet 时间,不能替代 heap_profile.ts_end、dump 窗口与最终完成状态来证明目标窗口完整。下列查询保留这些上下文供复查:
1 | SELECT name, idx, severity, source, value |
发布报告前检查
采集条件:
- heapprofd 原生路径从 Android 10 提供;本文示例以 Android 12+ 为范围,Java allocation sampling 从 Android 12 提供,仍需核对设备 producer 与权限。
- user build 上用 adb / shell 抓目标 App,通常需要
debuggable或<profileable android:shell="true"/>。 - 按 PID 抓运行中进程可能错过启动早期分配;按进程名等待启动能覆盖更多启动阶段。
- runtime profiling 不是立刻生效,目标进程很空闲时,下一波分配前可能还没启用。
- 同一个目标进程同时只能被一个相关 session profile;冲突时先确认是否有旧
perfettosession。
数据可信度:
- heapprofd stats、stackprofile stats、symbolization stats 必须过一遍;命中 overrun、non-finalized、unknown symbols 时降级。
- heapprofd 数字和 RSS 对不上很常见,碎片、线程缓存、allocator cache、ZRAM 都会造成差异。
结论边界:
Total malloc size高不等于泄漏,先和Unreleased malloc size、同一累计口径的 dump、业务操作时间点一起看。- 图形 backing 高不等于 heapprofd 一定高。Graphics/GL、dmabuf、GPU、Surface buffer 要单独成账。
- 把结论归类为
leak / peak / cache / churn / out-of-scope graphics memory / evidence insufficient,每类对应不同下一步动作。
把内存趋势落到调用栈
报告里先列内存趋势,再列 heapprofd 的采样条件、未释放分配和调用栈。如果上涨主要来自 GraphicBuffer、dma-buf 或 GPU texture,就改用图形内存证据,不能把 heapprofd 的空结果写成「没有内存问题」。
实战里可以按这个顺序走:
- 用 process stats、meminfo、smaps 或线上监控确认内存趋势。
- 如果增长落在 Native Heap / malloc wrapper / heapprofd 可见 allocator 路径,进入 heapprofd;如果只是 RSS/PSS 涨,先用 smaps_rollup、meminfo 分类、mmap/syscall 或 dmabuf/graphics 证据拆账。
- 在 UI 里看 Unreleased malloc size 和 flamegraph。
- 用 SQL 找大头,再回到 flamegraph 看完整调用栈。
- 补符号化、写清采样条件和可信度。
- 把结论归类为 leak、peak、cache、churn、图形内存账外问题或证据不足。
参考文档
- Memory: Callstack-based Allocation Profiling
- Memory: Java heap dumps
- Memory counters and events
- heapprofd design
- TraceConfig reference
- Track Events
- Android Log data source
- ProfilingManager
- Android Profiling module
原文源码基线为 b23c67be(2026-09-19),下方保留入口。本次另核对 v58.3 HeapprofdConfig、heap_profile 脚本、表定义、UI 区间指标、summary tree 与 syscall 采集边界。
关于我 && 博客
欢迎关注 Android Performance。