主线程上出现一段长 Binder 调用,慢的可能是服务端处理,也可能是事务派发、服务端线程排队或锁等待。这篇从一次调用出发,用 Perfetto 的 Binder 事件、线程状态和 Java monitor contention,把等待时间逐段分开。
这些信号需要在抓 Trace 时启用;看到主线程 Sleeping 或一个 futex 栈,只能确定它在等待,不能直接写成「Binder 慢」或「Java 锁慢」。
版本说明(2026-10 核查):本文保留原案例图;它们来自不同进程和采集现场,不拼成一次完整故障。Binder/ART 机制按 android-16.0.0_r1,SQL 与 UI 按 Perfetto v58.3 核对。录制事件、权限和厂商实现仍以目标设备为准;文末另标冻结机制的版本要求。
本文目录
- Perfetto 系列文章
- Binder 基础与案例
- Perfetto 观测准备
- Binder 分析工作流
- 假设案例:窗口管理延迟
- 假设案例:Binder 线程池饱和
- 最新平台特性与优化建议
- 总结
- 参考
- 关于我 && 博客
Perfetto 系列文章
- Android Perfetto 系列目录
- Android Perfetto 系列 1:Perfetto 工具简介
- Android Perfetto 系列 2:Perfetto Trace 抓取
- Android Perfetto 系列 3:熟悉 Perfetto View
- Android Perfetto 系列 4:使用命令行在本地打开超大 Trace
- Android Perfetto 系列 5:Android App 基于 Choreographer 的渲染流程
- Android Perfetto 系列 6:为什么是 120Hz?高刷新率的优势与挑战
- Android Perfetto 系列 7:MainThread 和 RenderThread 解读
- Android Perfetto 系列 8:深入理解 Vsync 机制与性能分析
- Android Perfetto 系列 9:CPU 信息解读
- Android Perfetto 系列 10:Binder 调度与锁竞争
- Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测
- Android Perfetto 系列 12:Trace 数据流与丢失排查
- Android Perfetto 系列 13:Perfetto SDK、Track Event 与 App 现场 Trace
- Android Perfetto 系列 14:heapprofd 与内存 Profiling
- Android Perfetto 系列 15:Boot Trace、长时间现场 Trace 与偶发问题抓取
- Android Perfetto 系列 16:GPU、Power Counters 与硬件瓶颈分析
- Android Perfetto 系列 17:专项场景自动化、问题清单与平台体系
- Android Perfetto 系列 18:响应速度实战,从输入事件到首帧反馈
- 视频(B站) - Android Perfetto 基础和案例分享
- 视频(B站) - Android Perfetto 分享 - 出图类型分享:AOSP、WebView、Flutter + OEM 系统优化分享
Binder 基础与案例
Binder 支持 Android 的跨进程对象调用。本文主要讨论 Java/AIDL 通过 /dev/binder 的远程路径;同进程本地接口可以直接调用,不一定进入驱动或线程池。
- Client:AIDL 生成的 Proxy 将参数写入 Parcel,经
IBinder.transact()等路径提交事务。 - Server:Java Stub 通过
onTransact()分发到服务实现;Native backend 有对应的原生路径,服务也不只在system_server。 - Binder Driver:管理事务、目标缓冲区、对象引用和调度相关机制。不同 Binder context/设备节点并非同一个通信域。
- Thread Pool:可按需创建接收线程,但同一节点的 Oneway 串行化、嵌套同步调用重入等也影响派发,不能只按“线程满了才排队”理解。
为什么需要 Binder?
Android 常用不同进程和 UID 隔离应用,一个应用也可以有多个进程。访问系统能力往往经过系统服务;普通同进程 Framework 方法并不必然跨进程。Binder 统一了身份、对象引用、生命周期和调用协议:
| IPC 方式 | 与 Binder 对象调用的区别 |
|---|---|
| Socket | 可通信并获取对端凭据,但接口与对象生命周期需另行设计 |
| Pipe | 提供字节流;匿名管道常依赖继承的 fd,命名管道并不限父子进程 |
| 共享内存 | 适合大数据,可有访问权限控制,但同步与生命周期需协调 |
Binder 可向服务端提供调用方身份,权限仍需服务端校验;异步事务的调用方 PID 不能作为始终可用的身份。同步调用等待 reply;远程 Oneway 不等服务端完成,但仍有序列化、驱动提交与可能的错误开销。优先级继承受事务、节点和调度策略限制,不保证消除锁等待。
官方线程模型还说明同步调用可重入:等待 reply 的线程可能执行嵌套回调。因此,跨 Binder 调用持锁可能引入死锁或状态重入问题。
从 App 开发者视角的案例
以图中的 AIDL::java::IActivityManager::attachApplication::server 为例,Android 16 的 IActivityManager.attachApplication 是同步方法。App 经 ActivityManager.getService() 取得 AIDL Proxy;它包装的底层远程对象是 BinderProxy,二者不是同一个类型。参数被序列化并提交后,服务端 Stub 分发到 AMS,处理完成再返回 reply。
下面的图中,App PID 8111 调用 system_server PID 1339 的线程 2055。客户端 binder transaction 约 5.255ms,主要为 Sleeping,也包含 Running/Runnable;服务端区间同样不是全程 Running。不同区间要分别看线程状态。
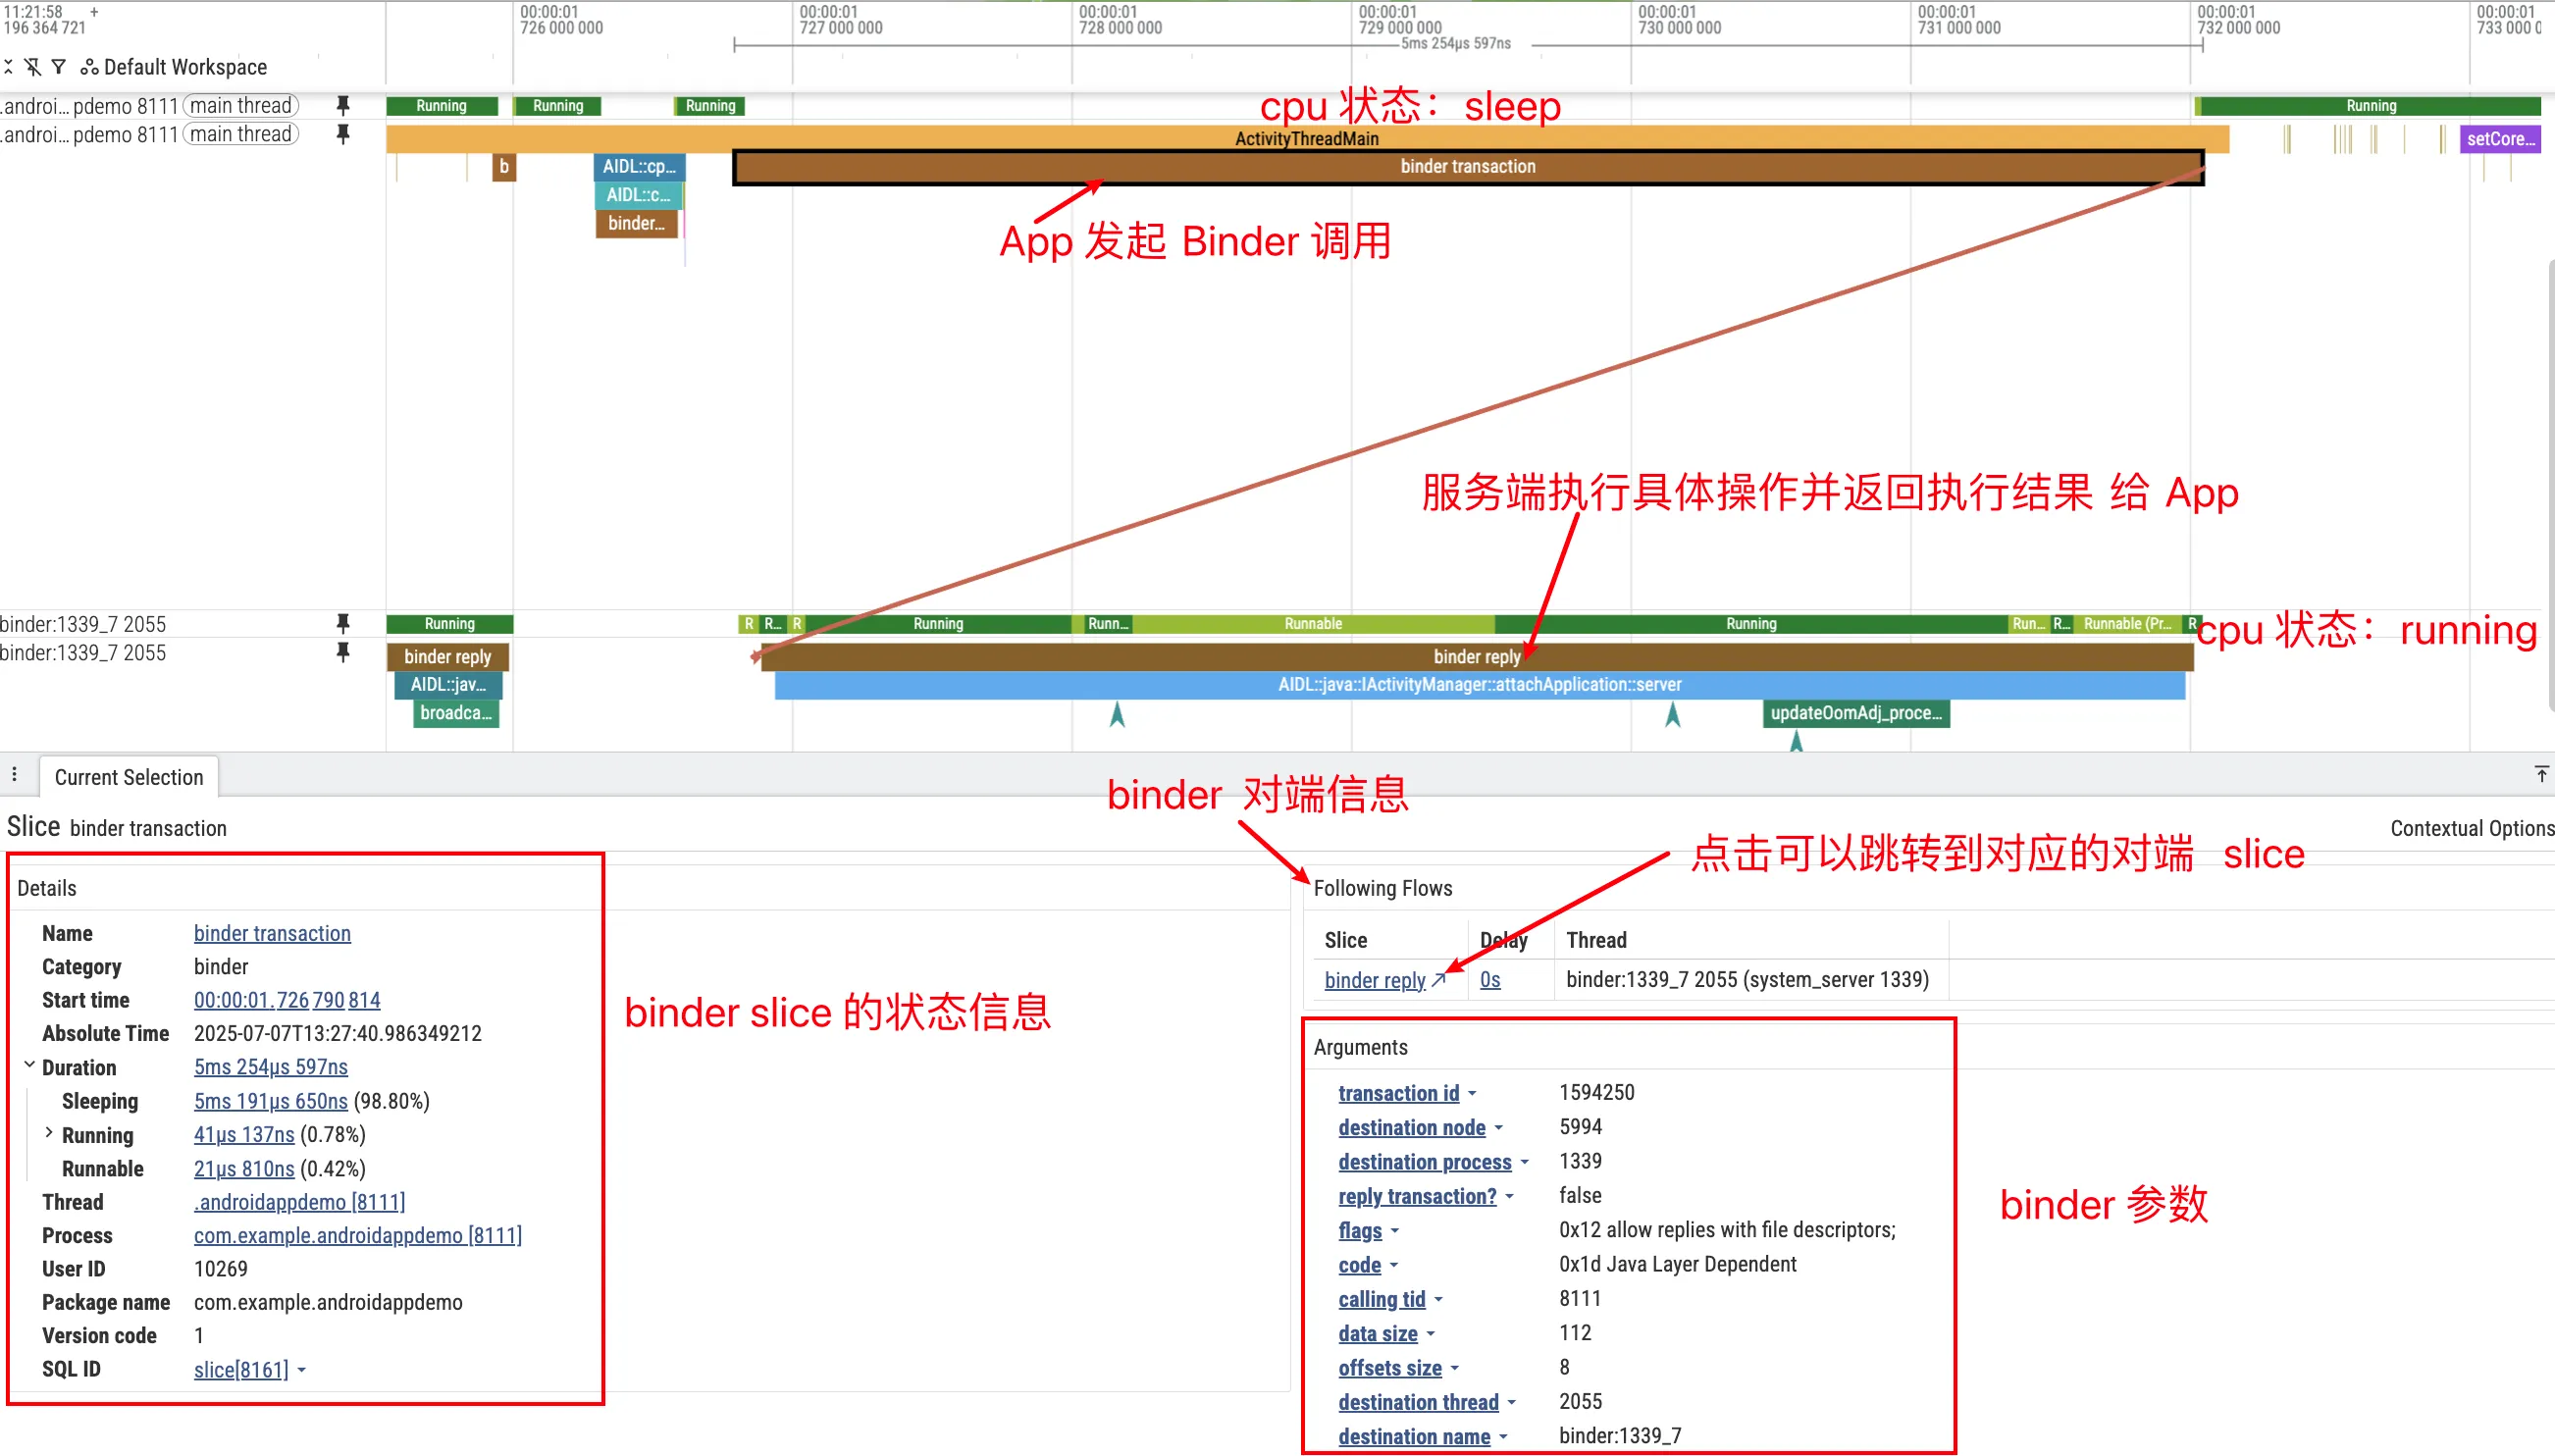
原始线程轨道上的 binder transaction、binder reply 与 flow 是事务关联证据;AIDL server slice 是另一层用户态标记,未采到时方法名可为空。Perfetto v58.3 的 aidl_name 保存完整标记,接口另在 interface 字段,不是 aidl_name=IActivityManager。
同步等待常发生在 Binder ioctl 路径,但 blocked_function 只在相应事件与符号可用时提供内核阻塞函数;它不是完整 Java/Native 栈。不能把 epoll_wait、ioctl(...) 一律当作该字段的固定值。
Perfetto 观测准备
要在 Perfetto 中诊断 Binder,需要提前准备好数据源与 Trace 配置。
数据源与轨道总览
Binder 分析需要把事务事件、调度状态和业务标记关联起来:
linux.ftrace:binder_transaction与binder_transaction_received关联发送/接收,包含同步请求、reply 或异步路径,不能只把 received 当服务端收到请求。sched 事件补充运行与唤醒;binder_transaction_alloc_buf是分配成功后的线索,不是分配失败日志。- atrace 类别与应用范围:
am、wm、dalvik等补 Framework/ART 标记。应用侧标记还需相应atrace_apps范围及设备支持。dalvik可启用 monitor contention,但不保证记录所有锁竞争或完整持锁生命周期。 linux.process_stats:补进程/线程名称与映射。它仍有采集开销,不能把开销等级当作所有设备的测量结论。
android.binder 与 android.monitor_contention 是 Trace Processor 的 SQL 模块,不是额外录制数据源。UI 可视化的名称和入口随版本变化;本文下方列出 v58.3 的实际入口。
Trace Config 推荐
将下面的 textproto 配置保存为 binder_config.pbtx。64MiB 环形缓冲区和 15s 是示例选择,长场景或高事件速率可能覆盖前部数据;应检查丢失统计。没有一份配置能保证覆盖所有 Android 12–17/OEM 设备。
1 | buffers { |
配置项说明
| 项目 | 能解释什么 | 限制 |
|---|---|---|
| Binder tracepoints | 事务及部分驱动行为 | 具体事件按内核确认,缺事件不代表没调用 |
| sched 事件 | Running/Runnable/Sleep 与唤醒 | 需足够完整的调度事件;不是业务调用栈 |
| atrace: am/wm/dalvik | 服务语义与 ART contention | 类别、应用范围和构建决定可见性 |
| process_stats | PID/TID、进程线程映射 | 仍需区分 trace 内 upid/utid 身份 |
需要 App 标记时,在 ftrace_config 增加 atrace_apps: "实际包名";"*" 范围更大且可能增加开销。symbolize_ksyms 解析已有内核符号引用,不会自动抓取完整内核调用栈。旧版 binder_lock/locked/unlock 在本文参照的 Linux v6.12 binder_trace.h 中不存在,因此不加入模板;不按 Android 大版本猜其可用性。
快速上手:3 步抓取与查看 Binder Trace
以下路径按支持该目录的 Android 12+ 设备说明,权限与配置读取方式见第 2 篇。输出文件名仅为示例,避免覆盖需要保留的 trace。
- 开始录制:在终端运行下列命令。第二条以前台方式录制,在它运行的 15s 内操作手机复现;不能等命令结束再操作。
1 | adb push binder_config.pbtx /data/misc/perfetto-configs/binder_config.pbtx |
- 等待录制完成再取文件,然后拖入 Perfetto UI:
1 | adb pull /data/misc/perfetto-traces/binder-review.pftrace . |
- 查看原始轨道与派生视图:先在客户端线程找
binder transaction/binder transaction async,通过 flow 跳到对端。Perfetto v58.3 的 AndroidBinderViz 插件建立Binder分组,下有Server Transaction Counts、Client Transaction Counts;锁插件注册命令Android Lock Contention: Toggle View。版本或插件不同,入口可能变化。没有派生轨道时,先用下面的 SQL 检查原始数据是否足够。
其他 Binder 分析工具
除了 Perfetto,还可以用两个工具辅助定位:am trace-ipc(系统自带)和 binder-trace(开源,侧重消息解析)。
am trace-ipc:Java 层 Binder 调用追踪
am trace-ipc 用于追踪 Java 层 Binder 调用堆栈。按 Android 16 的 AMS 实现,命令需要 SET_ACTIVITY_WATCHER 权限,目标进程还须通过可调试检查:系统为 debuggable build,或该进程本身可调试。普通 user 设备不能借此完整观察任意第三方 App;ADB shell 是否获准也需以设备结果为准。
基本用法很简单,就是”开始 → 操作 → 停止导出”三步:
1 | # 1. 开始追踪(系统会记录符合条件进程的 Binder 调用,通常以可调试进程为主) |
导出结果是堆栈次数统计。下面仅示意格式,不是一次实际采集结果;AIDL 方法归属与行号应以目标版本为准:
1 | Traces for process: com.example.app |
它会按进程分组,列出调用堆栈和次数(Count),用于识别捕获范围内的调用点与次数,不提供逐次调用耗时,也不包含所有 Native/本地 Binder 调用。
与 Perfetto 配合使用:Perfetto 看时间线与线程关系,trace-ipc 补充捕获范围内的 Java 发起栈。抓取堆栈有开销,需与正常运行区分。
适用场景:怀疑卡顿/ANR 与频繁 IPC 有关,或需要定位具体 Java 发起点。
binder-trace:实时 Binder 消息解析
binder-trace 基于 Frida 拦截并按接口结构定义解析消息。按本次核查的 README(提交 a8a9a06),要求 Python 3.9+、具备相应注入权限的设备/模拟器和匹配的 frida-server;README 列出的内置 Android 结构版本为 9–14,不能把 -a 11 示例套到 Android 16/17。
1 | # Android 11 example; use the actual device and process name |
-n 是进程名,不必等于包名;可按工具帮助使用 pid 或合适的结构目录。接口结构随 Android/OEM 变化,解析出的参数需校验。动态注入有开销,适合补消息语义,不能直接把该运行的时长当成未插桩性能。
Binder 分析工作流
拿到 Trace,先别大海捞针。找到目标事务,再按“看耗时 → 查线程 → 找等待对象”的顺序往下走。
步骤一:定位事务耗时
先确定问题窗口与客户端线程,寻找事务 slice 和 flow;有 AIDL 标记时再按接口/方法搜索。Sleeping 只说明等待,必须与事务或调用栈关联,才能归为 Binder 等待。
按 Perfetto v58.3 android.binder,同步事务使用解析器重建的 Binder 区间:
client_dur:客户端 Binder 事务 slice 的 wall duration,不是完整 Java API 的序列化前后耗时,也不必全是 Sleeping。server_dur:服务端binder reply区间的 wall duration,包含服务端 Running、等待和嵌套调用;不等于服务端纯 CPU 时间。dispatch_dur = server_ts - client_ts:从发送事件到接收事件的间隔,包含传输、排队、唤醒和调度等,不是纯线程池队列时长。return_dur = client_end - server_end:服务端结束到客户端事务结束的剩余时间;回程与客户端调度也可能慢。
1 | INCLUDE PERFETTO MODULE android.binder; |
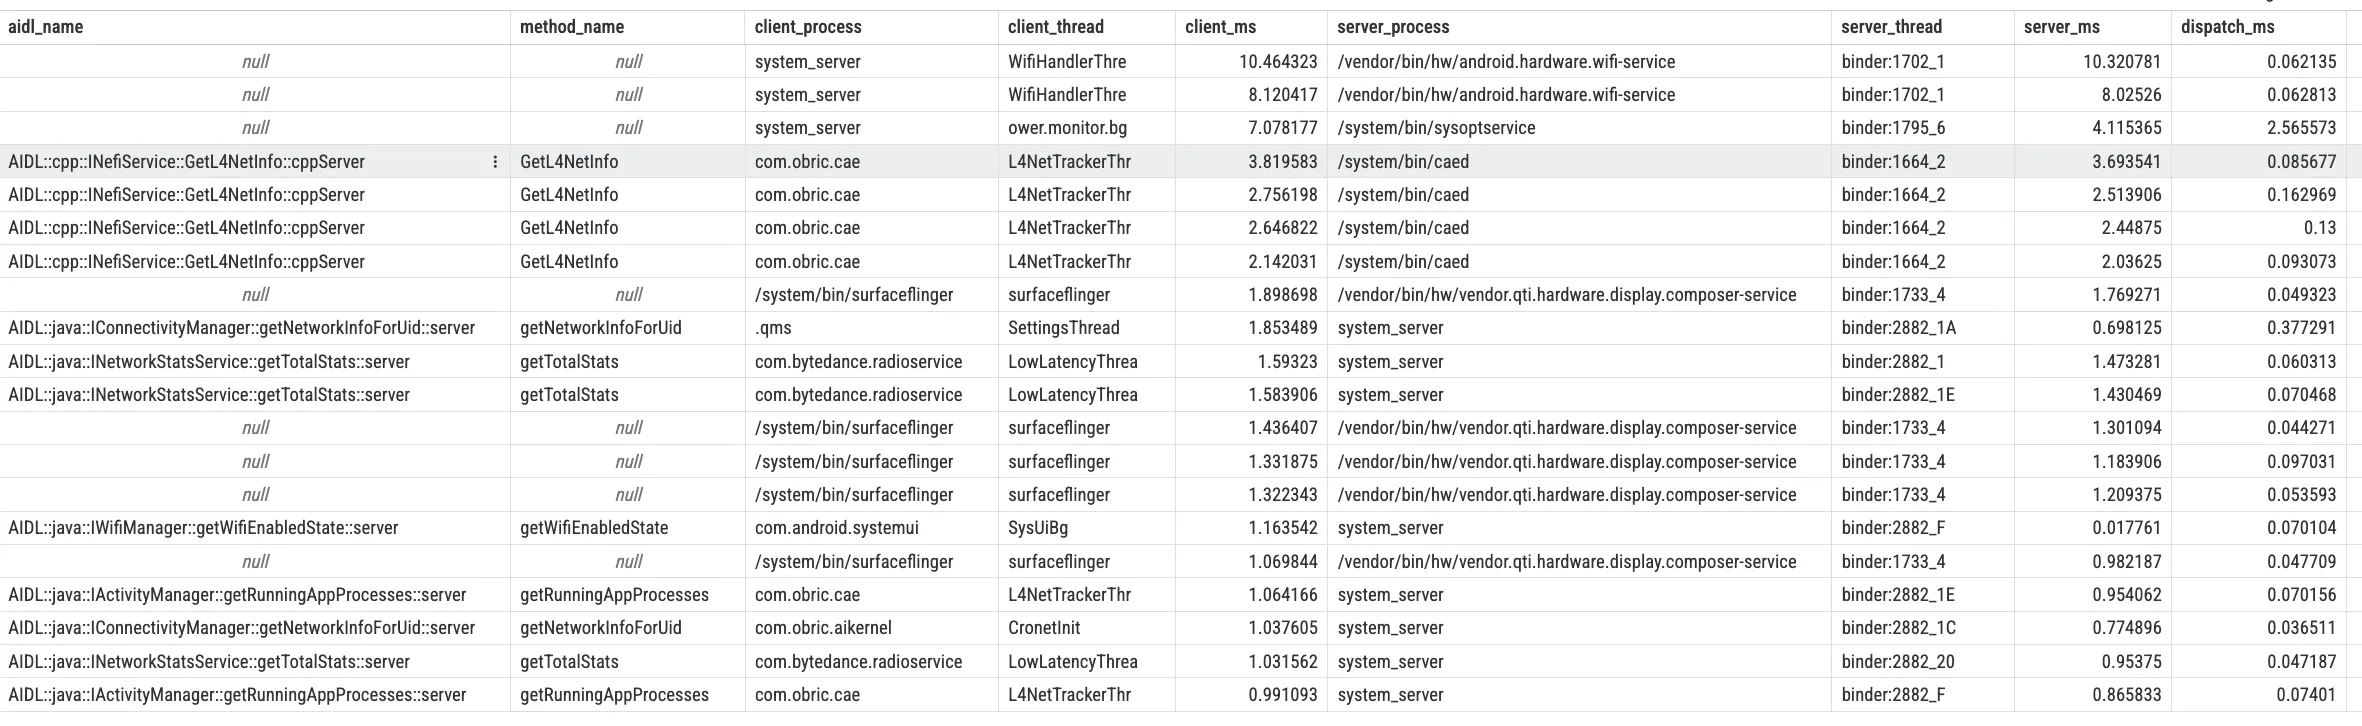
图是旧查询结果,保留作界面示例;新查询补身份与回程列。字段为空意味着无可解析标记,不是接口不存在。标准库会过滤不完整或不满足关联条件的事务,查不到不代表从未调用。
若 server 区间嵌在 client 区间内,三段时长可与 client 总时长对账;出现负 dispatch/return 时先查关联、时钟与丢事件,不直接截成零。派发慢查调度/线程池/串行化,server 慢看其状态和依赖,return 慢查客户端被唤醒后的调度。
步骤二:评估线程池与 Oneway 队列
发送到接收的延迟较大时,线程池是调查对象之一。这里先回答几个常见问题:一个进程到底有多少 Binder 线程?system_server 呢?什么情况下才能说线程池“耗尽”了?要结合可用线程和事务活动,再区分池容量、调度与节点串行化。
system_server 的 Binder 线程池规模
Android 16 ProcessState 的默认 mMaxThreads 为 15;SystemServer 把 sMaxBinderThreads 设为 31。这是交给驱动的按需增线程配置,不是进程最终总线程数。
startThreadPool() 另启动一个线程;显式 joinThreadPool() 加入的线程也可能增加总数。该版本的 getThreadPoolMaxTotalThreadCount() 专门区分这些来源。因此不能断言所有 App 恰好 15 条、system_server 恰好 31 条,也不能把 Java 与 Native 当成两套各 15 条的独立线程池。
正常池线程按需增长,不随瞬时负载降低自动缩回。实际分析应核对进程实例、Binder context、线程名与事务活动;仅数到若干 Binder: 轨道,不能证明已达到配置上限或每条都忙。
Binder 线程数、缓冲区与“Binder 耗尽”
大家说“Binder 个数不够”时,说的是线程、事务缓冲区,还是对象引用?先把这三类资源分开,再判断“耗尽”是否成立:
- 线程池:需看到可用接收线程均在事务/依赖处理中、新请求有派发延迟,并排除 runnable 调度、节点串行化和冻结。线程 S 可能闲等新工作,也可能忙于等待下游;Running/D 也不能单独证明全池饱和。同步重入路径还可能复用正在等 reply 的线程。
- 事务缓冲区:Android 文档用约 1MB 描述进程共享空间,不是每次事务都可独占 1MB。Android 16 libbinder 的映射请求还减去两个 page;可用空间受并发、异步配额、对象与分配布局影响。分配失败可返回错误,不应一律解释成排队变长。请求与回复都可能过大,异常本身不能确定哪一端已经完成了哪些业务。
- 对象与引用:长期保留引用会占内存并影响生命周期;没有一个与 15/31 线程数等价的通用“Binder 对象数”上限。须看实际驱动/进程统计,不能据此预判不会影响性能。
大块数据可考虑共享内存、文件或 ParcelFileDescriptor,并设计权限、生命周期和错误处理。Bitmap 的 Parcel 行为随实现/形式变化,不能只按像素大小推断它必全部内联;应测实际 Parcel 及传递路径。增加线程不是缓冲区问题的通用解法。
Oneway 的识别与等待:远程调用不等服务端业务 reply,但客户端仍进行序列化、驱动交互和提交确认;不能说“立即返回且绝不阻塞”。同进程 local 接口的调用也不因 oneway 自动切到后台。使用事务 flags、binder transaction async/binder async rcv 及 android_binder_txns.is_sync=0 交叉核对,而不是依赖固定 [oneway] 后缀。
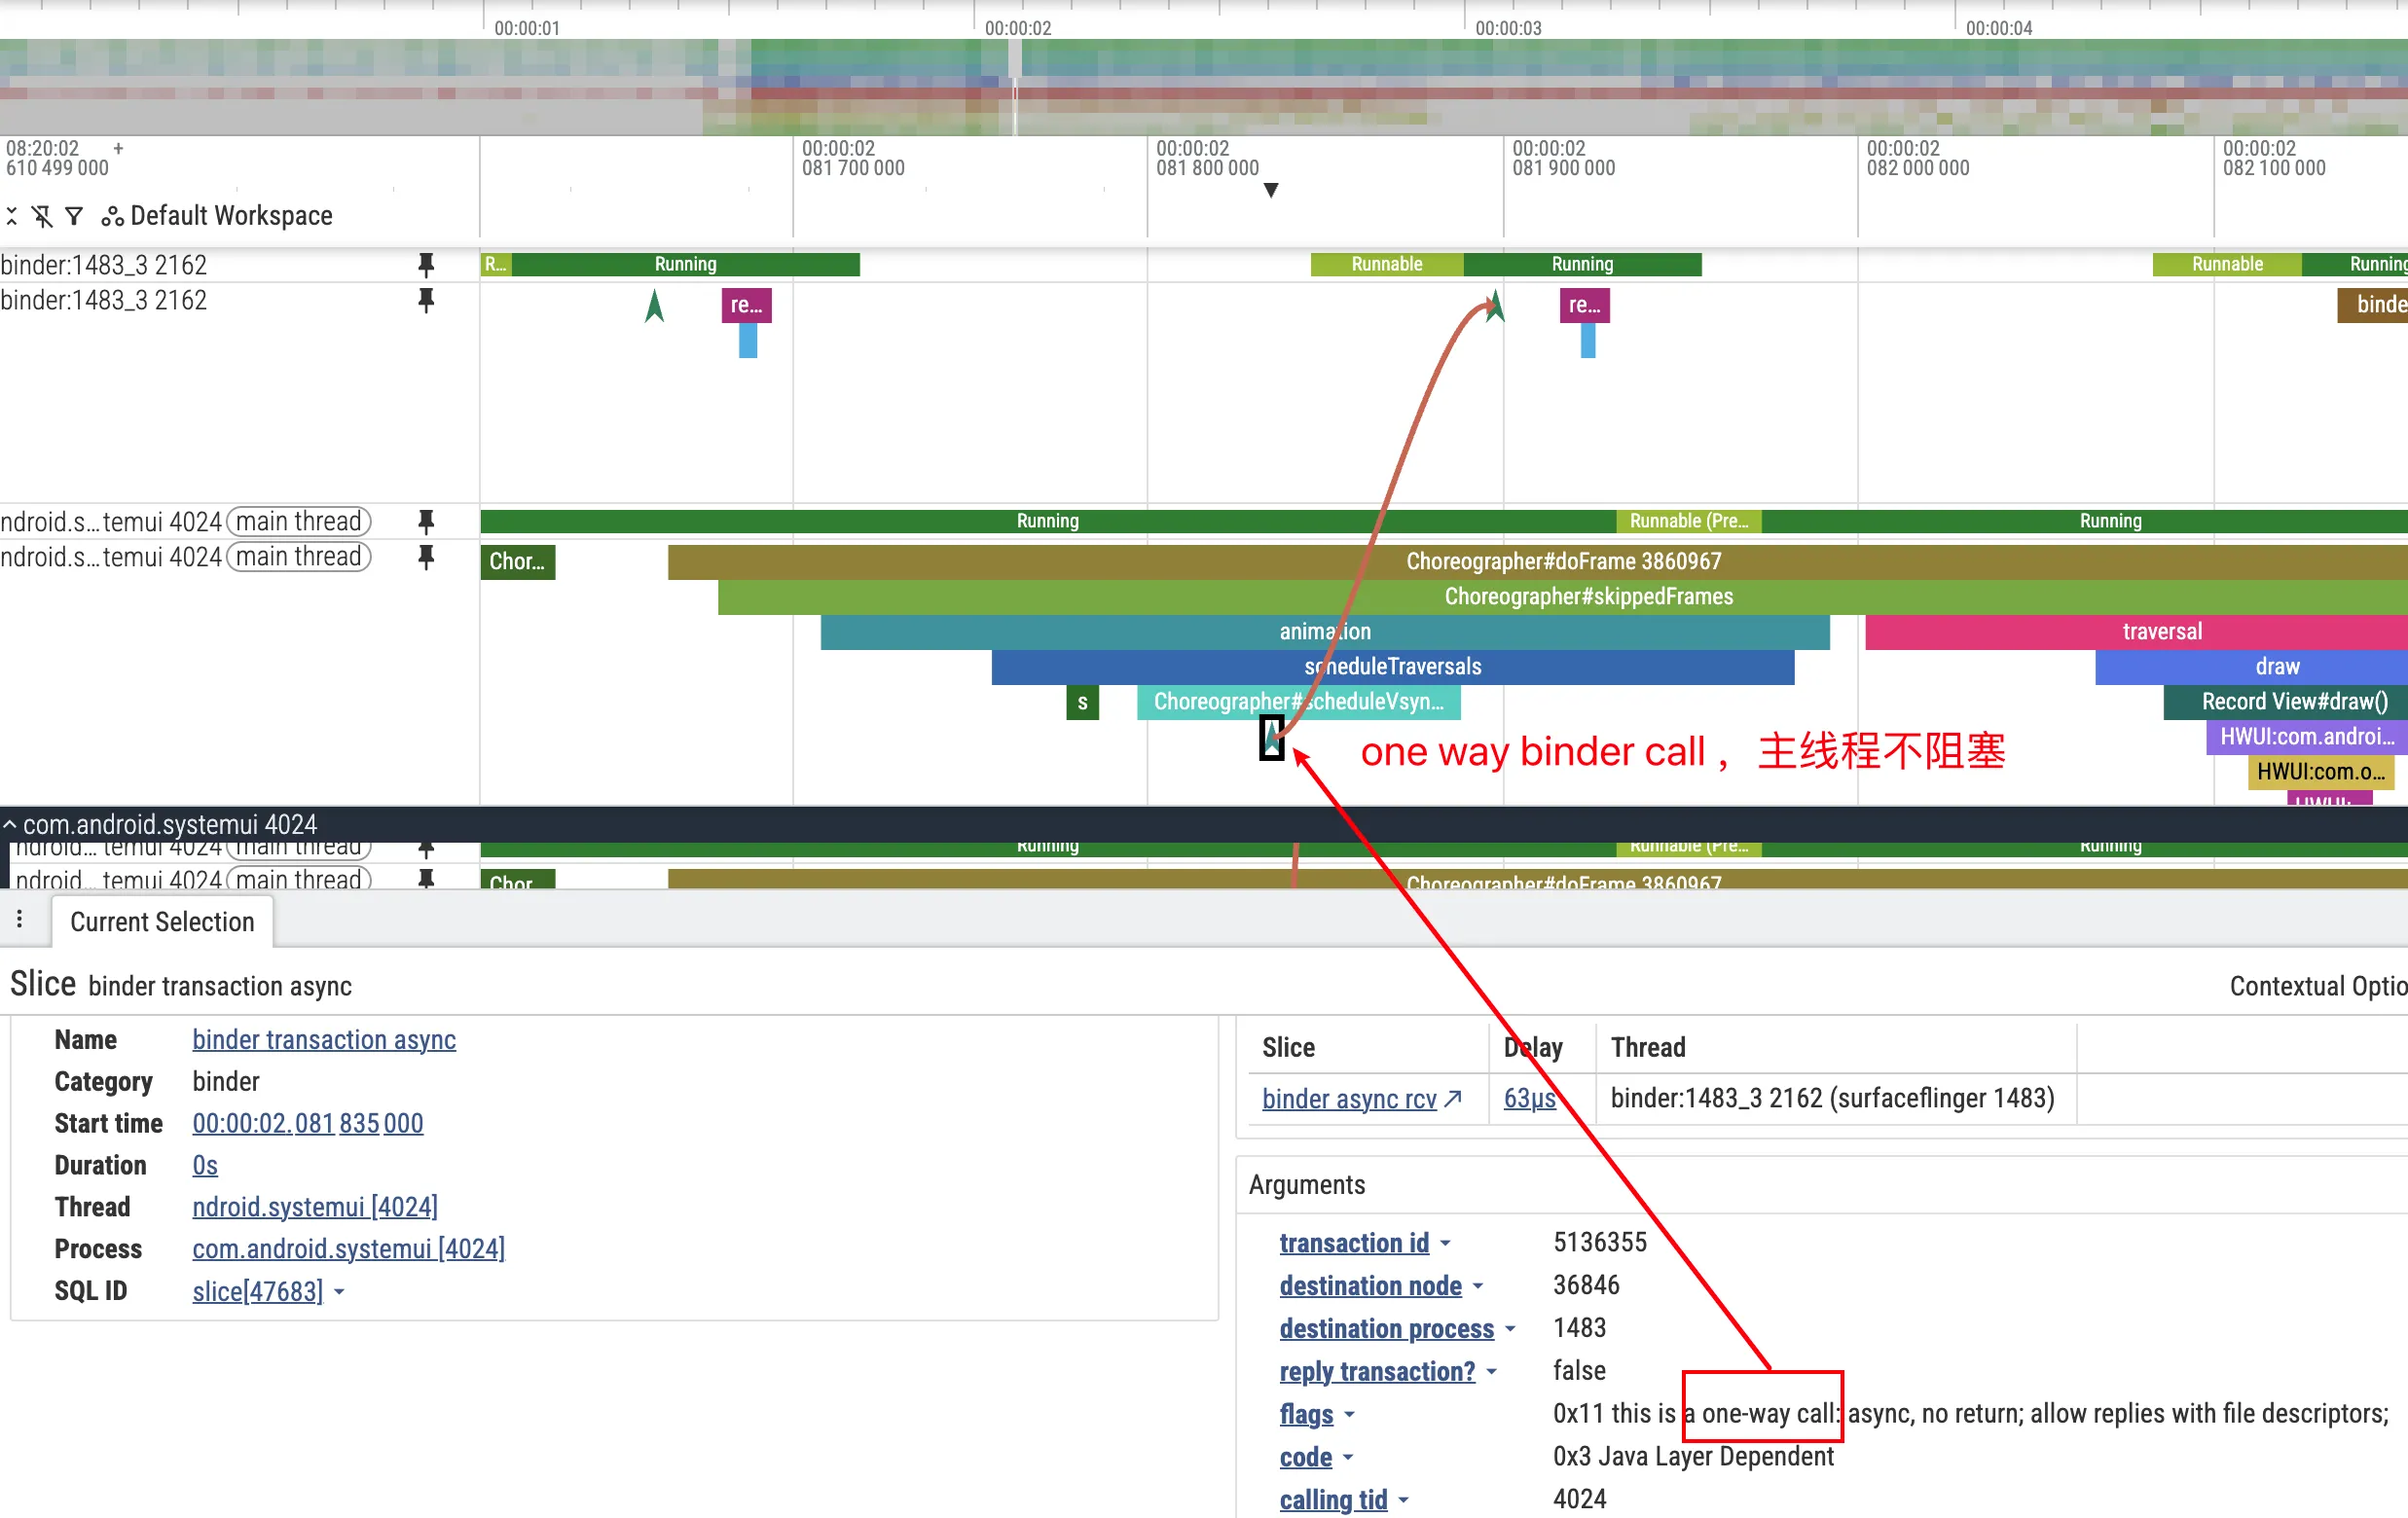
图中 SystemUI 4024 向 SurfaceFlinger 1483 发起异步事务,flags 为 0x11。发送 slice 的 Duration=0s 是瞬时标记,flow 延迟约 63µs;它不测整个 Java 调用开销,也不证明所有 Oneway 都无等待。v58.3 的异步表使用接收瞬时事件,服务方法时长可由可用的 aidl_dur 辅助观察,不能照搬同步 server_dur 解释。
同一 Binder 节点的异步事务串行接收处理,不同节点可以并发;大量请求可能积压。密集短 slice 是处理/发送活动,不等于队列深度,应关联发送与接收并限定节点和数据完整性。AMS 与 WMS 的普通同进程方法调用不是跨进程 Binder;系统服务也可能嵌套调用其他进程。具体影响哪个客户端,需沿真实依赖继续查。
步骤三:排查锁竞争
服务端事务期间的 S/D/Runnable 需要分别解释。D 是不可中断睡眠,不专指磁盘;futex 等待可来自 Java monitor、Native 锁或条件变量,不能仅靠符号给锁分类。
Java monitor contention:采到 ART 的 monitor contention with owner ... 时,可用 v58.3 monitor_contention 模块解析。blocked_* 是当前等待者,blocking_* 是记录到的持有者信息;持有者/方法是争用时的快照,不保证整个等待期间始终由同一个线程持锁。
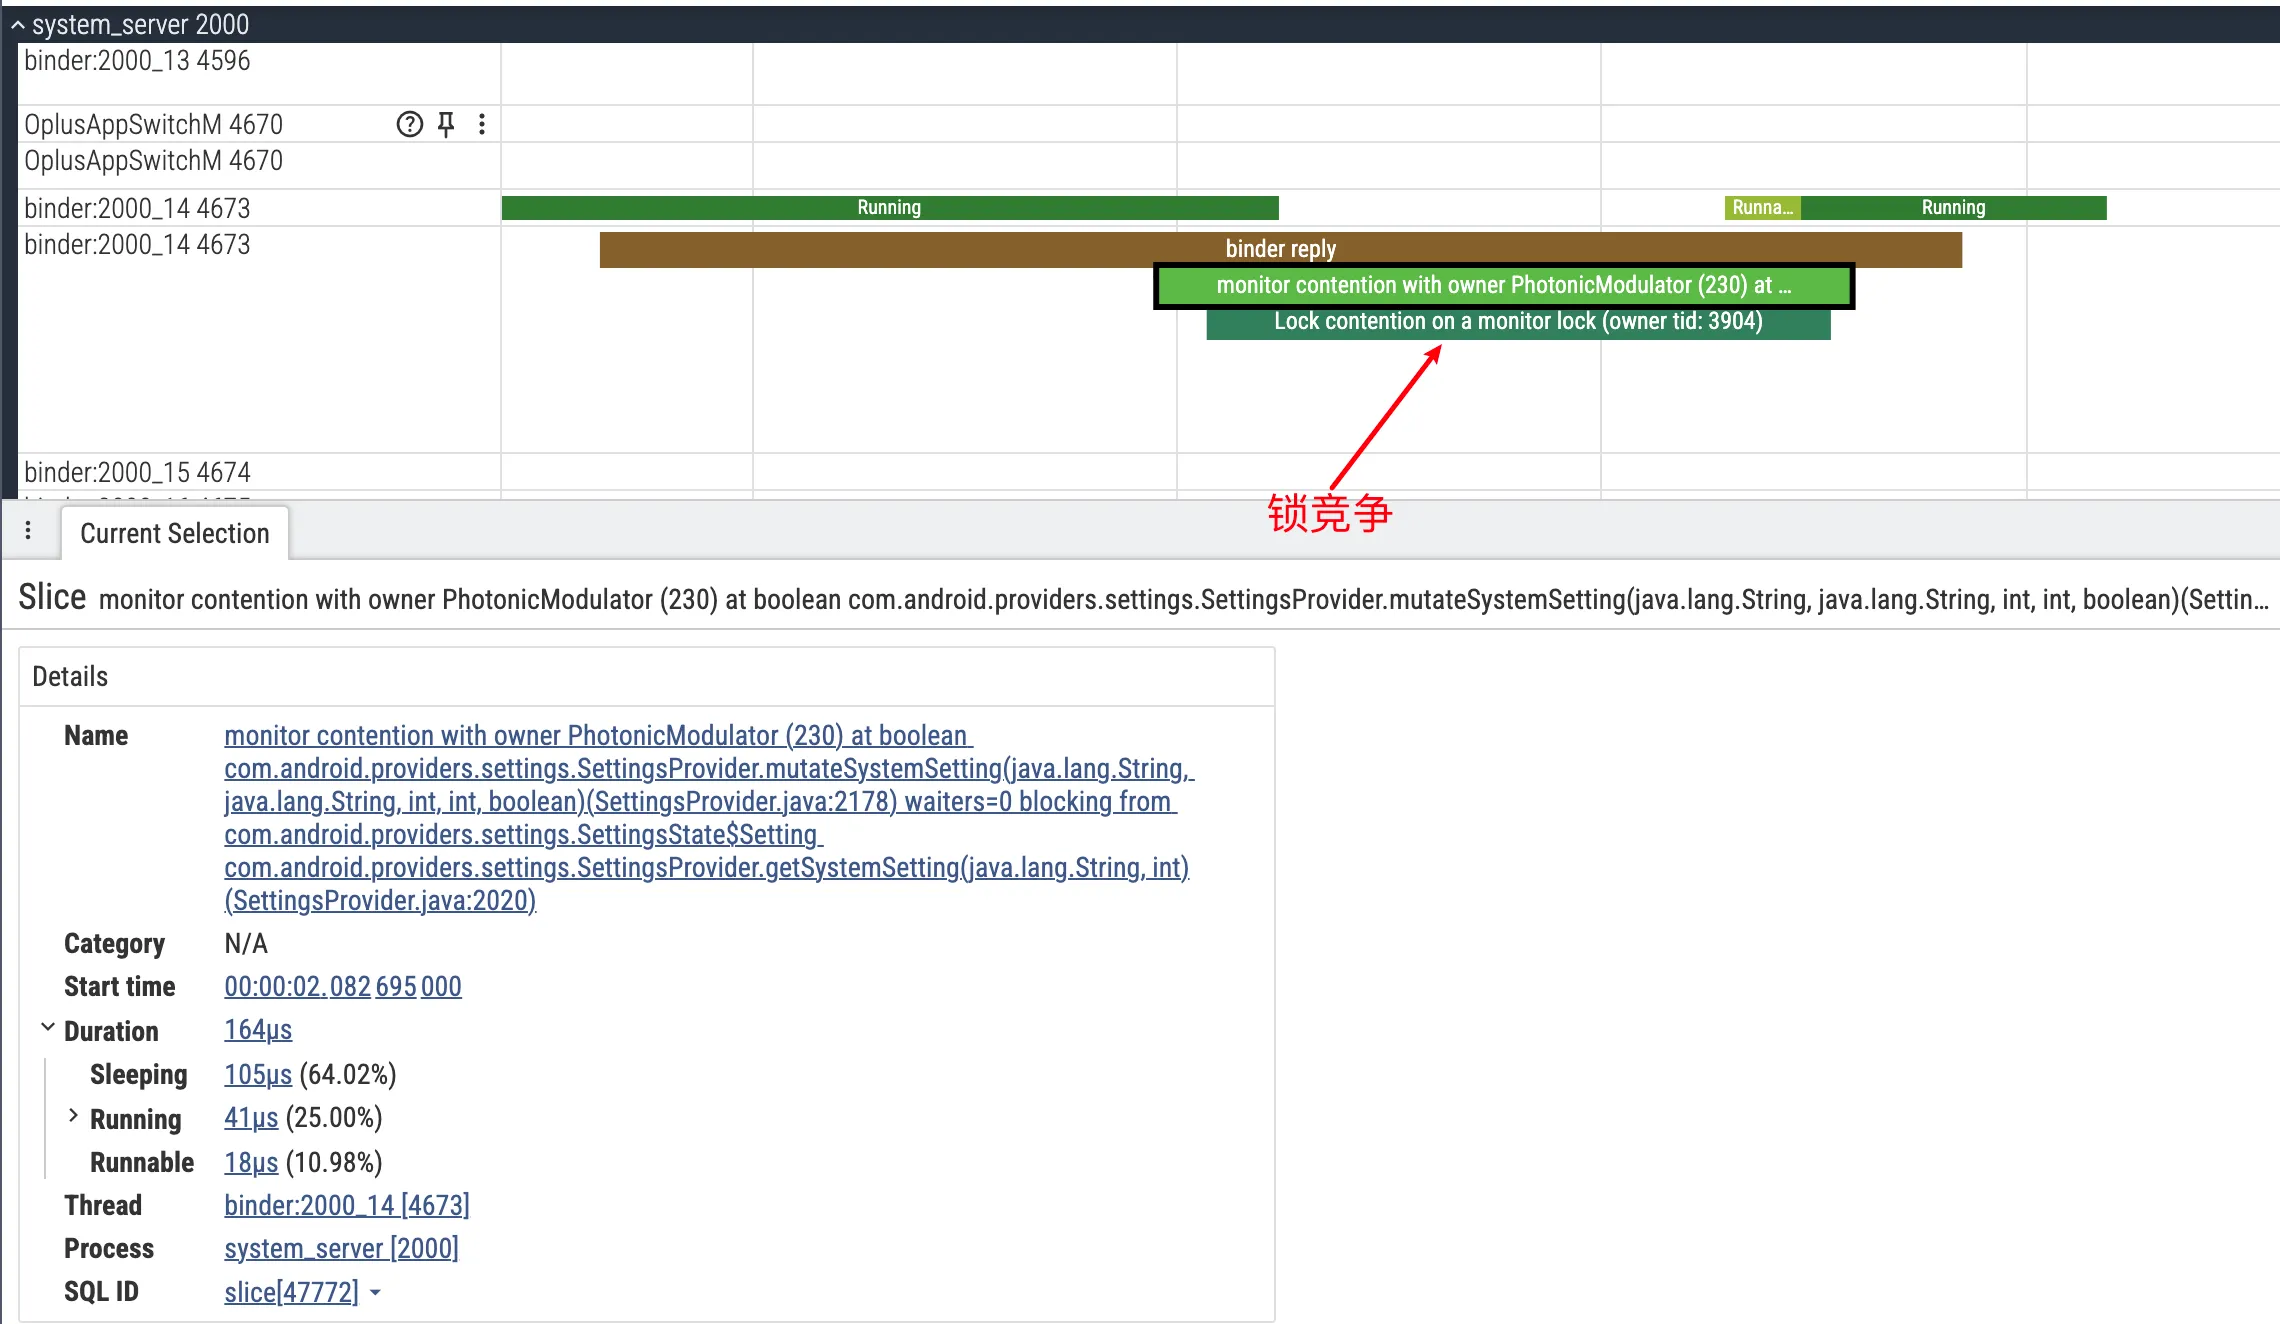
图中是 SettingsProvider 相关竞争,持有者标记为 PhotonicModulator,不是 WindowManagerGlobalLock。164µs 的竞争区间包含约 105µs Sleeping、41µs Running、18µs Runnable,因此 contention duration 不等于纯睡眠,更不是持有者完整持锁时间。
Native/kernel 等待:pthread_mutex_lock 是用户态库路径,mutex/rwsem 等可属于内核锁;sched_blocked_reason 提供的内核阻塞位置不是完整 Native 栈。应结合调用栈、锁标记、调度和 I/O 事件继续分析,也不能假设 Native 竞争比 Java 更少见。
使用 SQL 统计 system_server 中的 Java Monitor Contention(可选)
先用标准库解析,不手工拆 slice 名;按 upid/utid 区分同名进程和线程。这里按名称列出各 system_server 实例,并保留身份列:
1 | INCLUDE PERFETTO MODULE android.monitor_contention; |
Android 16 ART 的 waiters= 来自加入等待者计数之前的值,waiter_count+1 可近似表达当次记录包含自己的计数,不是全区间最大等待线程数或查询时的实时队列长度。这里直接输出原始 waiter_count,保留未知为 NULL。
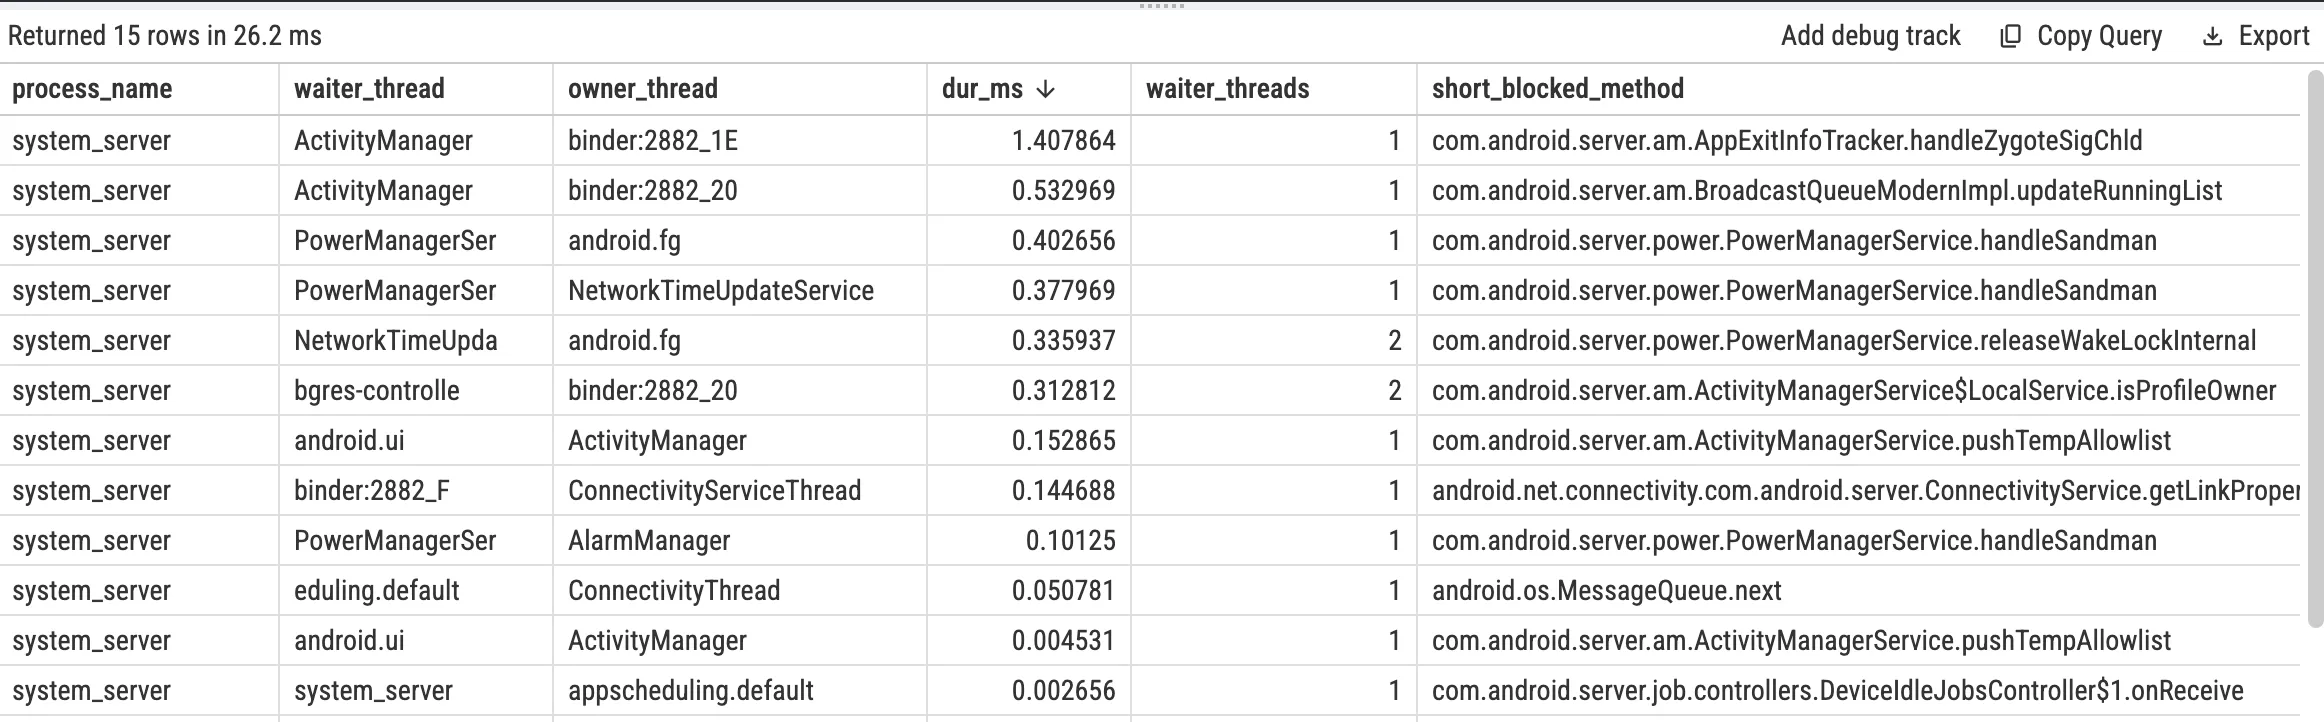
图是旧查询的 waiter_threads 列;不要把它与新列混用。查不到数据时,检查 dalvik、应用范围、构建/符号及事件格式和丢失;无结果不能证明没有竞争。
假设案例:窗口管理延迟
以下两例是分析步骤的假设示例,不是上方截图的实测结论,也没有附可核对的原始 trace。数字用于说明如何对账。
假设 60Hz 场景中,主线程某次 doFrame 持续 30ms,其中有 18ms 与同步 IActivityTaskManager.startActivity 事务重合。60Hz 的 16.67ms 是刷新间隔,真实截止时间还需 FrameTimeline/流水线确认,不能只按 doFrame >16.67ms 就判定呈现结果。
- 用 flow 确认服务端线程,不由 S 状态猜接口。
- 假设服务端事务 15ms,其中 monitor contention 为 12ms:检查该竞争是否位于事务关键路径、owner 是否可解析,以及剩余约 3ms 的客户端前后延迟分布。
- 若持有者快照指向
android.anim,继续核对它在重叠窗口做什么。只有日志/栈或相关锁证据支持时,才能命名为 WindowManagerGlobalLock;方法名或一条 contention 不一定暴露锁对象类型。
优化可从减少冗余启动 IPC、缩短已确认的持锁工作入手;是否改善可见卡顿,须重新测量同场景。
假设案例:Binder 线程池饱和
再假设多个客户端在同一窗口等待 system_server,并观察到一批 IPackageManager 查询。不能只凭“Binder 线程图很满”宣布线程池耗尽:
- 确认等待确属这些事务,区分不同 upid、节点和时间窗口。
- 核对接收线程是否都被占用、是否还有可用线程/可增线程,以及 Runnable、冻结和串行化限制。
- 若每次服务端约 5ms,几百次调用是否足以饱和仍取决于并发数、到达率、锁和 CPU 负载。较大的 dispatch 只是待解释的前段延迟。
- 只有这些证据支持同一条排队链,才把突发调用视为该次响应变慢的原因。
优化应选语义合适的批量接口、去重/限流并测效果。getPackagesForUid 查询某个 UID 的包名,不是任意 PackageManager 调用的批量替代品;系统侧可评估服务级限流或热点优化。
最新平台特性与优化建议
Cached apps freezer:官方说明将框架支持起点列为 Android 11 / API 30;设备还需适用的 cgroup/内核与启用策略,不能按“Android 12+ 一律冻结”判断。冻结进程不能正常处理事务。对冻结目标的同步调用会失败,框架检查到相应 Binder 状态后可终止目标;异步事务可暂存,但缓冲区有限,过量也可能触发终止。cached 不等于已经 frozen,需查实际冻结事件。
Frozen-callee policy(API 36):RemoteCallbackList.Builder 可选择 DROP、ENQUEUE_MOST_RECENT、ENQUEUE_ALL。Android 16 源码中,这些策略用于 broadcast(Consumer);旧的 beginBroadcast() 在非 UNSET 策略下会抛异常。ENQUEUE_ALL 也有队列上限(该版本默认 1000,可配置,满时移除最早回调),不是无限缓存。内核不支持冻结通知时该实现会回退,因此 API 存在不等于每台设备都按策略排队。
Binder Heavy Hitter Watcher:Android 16 实现在调用批次里识别高频调用类型,按调用 UID、Binder 类和事务 code 等分组;这是频次热点,不等于 CPU/延迟热点。启用、阈值和输出由系统配置决定。
优化建议:
- Oneway 适合确实不需要同步结果的协议,同时设计顺序、背压、失败与进程死亡处理;不要靠改关键字隐藏等待。
- 大数据要量化 Parcel 和并发占用,再选择共享内存/fd等方式;出现异常也不能盲目重试有副作用的事务。
- 避免把耗时不可控的远程服务放在 UI 关键路径。仅在 API 线程约束允许时移至后台,并处理生命周期、结果过期和取消;某些 UI/Framework 调用不能任意换线程。
总结
从问题窗口的 Binder 等待出发,先关联事务,再把客户端区间拆成派发、服务端处理与回程。结合线程状态、池可用性和 contention 证据解释每一段;缺事件时保留未知,不用一个 S/D 状态或忙碌线程图代替根因。
参考
- 理解Android Binder机制1/3:驱动篇
- PerfettoSQL stdlib - android.binder
- Perfetto Documentation - Ftrace
- Android Source - Binder
- Android Developers - Parcel and Bundle
- binder-trace - Wireshark for Binder
- Android 16 AMS:Binder tracking 权限与进程检查
关于我 && 博客
- 博主个人介绍
- 本博客内容导航
- Android性能优化知识星球:历史社群介绍,2026 年已关闭。
一个人可以走的更快 , 一群人可以走的更远