

开机慢、亮屏后偶发卡顿或几小时后才出现的音频断续,通常等不到工程师连上电脑再按「开始录制」。要保留问题发生前的调度、帧或音频事件,采集配置必须提前在设备上运行。
现场抓取要先确定触发点前后各保留多久,再选 Ring Buffer、周期写文件或 trigger。文件写出后,还要确认问题窗口没有被覆盖、关键数据源没有丢失。设备开机属于更早的特殊窗口,单独处理。
版本说明(2026-10 核查):以下配置和命令以 Perfetto v58.3 为核查基线。Android 版本、设备端 perfetto CLI、traced 服务和主机分析工具需分别确认;Android 14 支持 session clone,不代表自带 v49+ 的
--clone-by-name。write_flush_mode 属于 v54+,旧设备应删除不支持字段并核对该版本的手动 flush 策略。
Perfetto 系列文章
- Android Perfetto 系列目录
- Android Perfetto 系列 1:Perfetto 工具简介
- Android Perfetto 系列 2:Perfetto Trace 抓取
- Android Perfetto 系列 3:熟悉 Perfetto View
- Android Perfetto 系列 4:使用命令行在本地打开超大 Trace
- Android Perfetto 系列 5:Android App 基于 Choreographer 的渲染流程
- Android Perfetto 系列 6:为什么是 120Hz?高刷新率的优势与挑战
- Android Perfetto 系列 7:MainThread 和 RenderThread 解读
- Android Perfetto 系列 8:深入理解 Vsync 机制与性能分析
- Android Perfetto 系列 9:CPU 信息解读
- Android Perfetto 系列 10:Binder 调度与锁竞争
- Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测
- Android Perfetto 系列 12:Trace 数据流与丢失排查
- Android Perfetto 系列 13:Perfetto SDK、Track Event 与 App 现场 Trace
- Android Perfetto 系列 14:heapprofd 与内存 Profiling
- Android Perfetto 系列 15:Boot Trace、长时间现场 Trace 与偶发问题抓取
- Android Perfetto 系列 16:GPU、Power Counters 与硬件瓶颈分析
- Android Perfetto 系列 17:专项场景自动化、问题清单与平台体系
- Android Perfetto 系列 18:响应速度实战,从输入事件到首帧反馈
- 视频(B站) - Android Perfetto 基础和案例分享
- 视频(B站) - Android Perfetto 分享 - 出图类型分享:AOSP、WebView、Flutter + OEM 系统优化分享
长录制期间,数据源持续写入,Buffer 容量和文件周期决定最后能留下哪一段。配置里只放目标问题需要的信号,并按估计写入速率计算保留窗口;开太多数据源容易让根因发生前的事件先被覆盖。
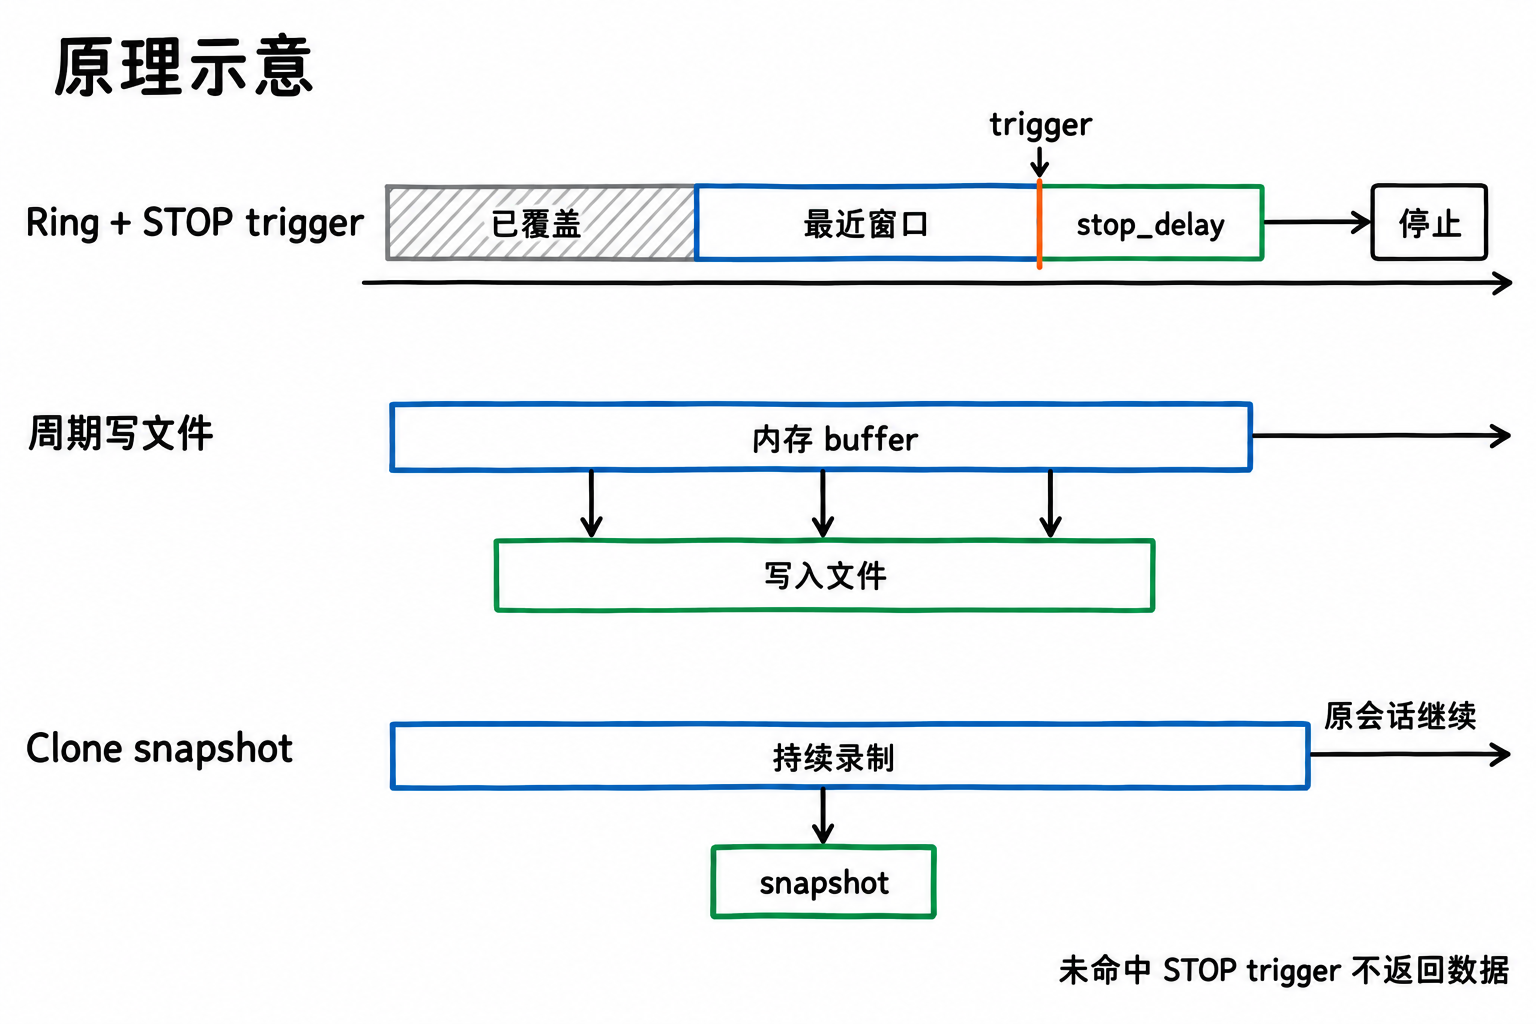
示意图:STOP trigger 封存触发窗口,周期写文件分批落盘,clone 则保留原会话继续运行。
长 Trace 先设计证据窗口
长 Trace 的核心是取舍:问题前后各保留多少,哪些数据源值得留下。开始写配置前,先把问题窗口问清楚:
| 问题 | 影响配置的地方 |
|---|---|
| 问题多久复现一次 | duration_ms、是否需要后台运行、是否需要周期 snapshot |
| 根因在问题前还是问题后 | 选择 STOP trigger 还是 START trigger |
| 需要保留问题前多少秒 | Ring Buffer 大小、数据源宽度、写文件周期 |
| 用户能不能手工停止 | 是否需要自动 trigger、是否接入 bugreport |
| 早期 ADB 不可用 | Boot Trace、平台预置、init/service 触发或厂商方案 |
| trace 启动后可能断 USB | --background-wait、detached mode、snapshot 或后台服务 |
| 文件最大能多大 | max_file_size_bytes、上传策略、本地 TTL |
| 数据是否敏感 | log tag 白名单、是否禁用 atrace_apps: "*" |
偶发 UI 卡顿通常需要问题前几十秒;温升降频可能需要几分钟趋势;车机长稳问题可能要跑几个小时。这类场景通常只周期性拉取 snapshot,或只上传 summary。
常见场景可以先映射到 preset,再写 TraceConfig:
| 场景 | 推荐模式 | 触发和验收重点 |
|---|---|---|
| UI 偶发卡顿 | Ring Buffer + STOP trigger | App marker、FrameTimeline 覆盖目标窗口、触发前窗口足够 |
| ANR 前兆 | Ring Buffer + STOP trigger | 主线程、Binder、锁等待、I/O 和关键业务阶段同时在场 |
| 温升降频 | write_into_file 或 snapshot |
CPU freq、idle、thermal 状态和 App 关键阶段按分钟级趋势保留 |
| 业务 timeout | App marker + STOP/START trigger | 要保留 timeout 前后用 STOP 并留足 stop_delay;仅需事后窗口时才用 START |
| 音频 underrun | Ring Buffer + STOP trigger | audio/server 事件、sched、binder、wakeups 和 underrun marker 同步 |
现场采集先受设备和权限限制
现场方案不能只看 TraceConfig,还要看设备版本、build 类型和触发者权限。
| 环境 | 可以依赖什么 | 不该假设什么 |
|---|---|---|
| userdebug / root 研发设备 | 按实际权限使用配置目录、log和更多系统事件 | root不保证adb root可用,仍需检查adbd/SELinux、log白名单与资源预算 |
| user build + adb shell | 常规系统 Trace、包名限定的 atrace、审核过的 preset | 不默认依赖 android.log;不能假设任意配置路径都可读;优先使用 /data/misc/perfetto-configs |
| 普通 App | 记录 App 侧 ATrace / Track Event,激活预先声明的 trigger | 本例 trigger 合同不授予系统 consumer 权限;ProfilingManager 等受限请求接口另按 API/策略处理 |
| CPU / native / Java profiling | 按数据源要求检查 debuggable、profileable、Android 版本 |
不把 <profileable> 当成现场系统 Trace 的通用权限开关 |
文本 proto 配置的扩展名可以是 .pbtxt 或 .pbtx;解析方式由 perfetto --txt 或工具链里的编码步骤决定。本文后面统一用 .pbtxt 做文件名。
各节配置不能直接拼接:后台停止示例的field.pbtxt应使用含数据源、duration与write_into_file的完整配置;STOP模式则按trigger生命周期处理,不能用SIGINT兜底获取未命中现场。每轮输出路径要唯一,固定文件名仅用于单轮示例,使用前先归档旧产物。
Boot Trace 是特殊现场窗口
App 冷启动和系统开机是两类问题。App 启动路径在旧的 Systrace 响应速度实战里已经讲过,第 05 篇也覆盖了启动后的渲染链路,这里只处理设备级开机:ADB 还没可用、但 Android 已经进入 /data 挂载后的启动阶段,怎么把系统 Trace 抓全、看准、写成可复查结论。
需要 Boot Trace 的场景通常有几类:
| 现象 | 为什么普通 trace 不够 |
|---|---|
| 开机到桌面慢 | 问题发生在 ADB 可用前 |
| OTA 后第一次启动慢 | init、zygote、dexopt、system_server 都要看 |
| Launcher 首帧晚 | 要同时看 system_server、SurfaceFlinger、Launcher |
| 某服务开机阻塞 | 需要 init/service manager/Binder 上下文 |
| 用户说“重启后很久才能用” | 要先定义 ready 标准 |
Boot Trace 是平台或系统启动专项窗口;App 冷启动不走这条路线。分析前要先讲边界:
- Android boot tracing 是 Android 13+ 的能力。更早版本需要厂商自己的启动采集方案。
- v58.3 的 init 规则还要求 persist.traced.enable=1、traced 已监听且 sys.boot_completed 尚未设置;persistent properties 加载发生在 /data 挂载后。不覆盖 PMIC 上电、bootloader、kernel early boot、first-stage init。更早阶段要靠 pstore、kernel cmdline/ftrace persistent buffer 或 vendor init instrumentation。
- 这类流程通常假设研发设备或 userdebug 上可以
adb root。生产 user build 需要平台预置、工程版本或厂商诊断入口。 - UI 的相对时间轴起点不等于电源键按下或 PMIC 上电;SQL
ts保留 Trace Processor 统一时钟域下的时间戳,并不会自动从 tracing 开始归零。报告里比较同一份 Trace 内的相对阶段,不要把不同设备的绝对ts硬比较。 - “开机完成”没有唯一标准。Launcher 第一帧、可输入、网络可用、导航服务 ready、后台任务完成,可能是不同团队的指标。
- 不写文件模式通常结束后才有输出;write_into_file 模式可以提前看到部分文件,但出现文件不等于录制完成。
persist.debug.perfetto.boottrace是 one-shot,下一次 boot 前要重新设置。
boottrace.pbtxt 是该启动入口要求的固定文本配置文件名,不能换成 binary proto。duration_ms 给这轮采集设终点;本例使用 write_flush_mode: WRITE_FLUSH_AUTO,写周期5秒时由v58.3自动按5秒请求flush,不能同时假定 flush_period_ms:10000 生效。第一版不要太贪心,先抓调度、进程生命周期和少量 ATrace,再按 ready 标准加信号。
DISCARD 保留未读的早期数据,但在消费者读取前写满仍会丢新事件;RING 则覆盖未读旧事件。这里已开周期写文件,容量应覆盖两次实际读取间的峰值和延迟,而不是直接按90秒全量估算。128 MiB 是示例预算,已占满 extra guardrails 默认总buffer上限,不能再无条件叠加其他buffer。
1 | duration_ms: 90000 |
下面流程用于已具备root权限的研发设备。先归档设备上上一次 boottrace:init 开始新录制时会删除同路径旧文件。脚本校验 boot id 已变化、one-shot 属性已消费、专用 init service 已停止,再检查非空输出;这些还不替代之后的内容验收。
1 | adb root || exit 1 |
拿到 Boot Trace 后,先验收再分析:
本例没有开启 FrameTimeline 或特定的 ready marker。看见 Launcher 进程、sched 或首次绘制标记,不等于已证明首帧呈现/可输入;若这是验收目标,补相应数据源、业务标记或外部观测。
- Trace 是否覆盖从
/data挂载后的 Android boot 窗口到目标 ready 点。 stats里是否有 data loss、packet loss、ftrace setup error。- init、system_server、surfaceflinger、launcher 这些进程是否可见。
- process stats、sched、freq 是否都有数据;log 只在配置和 build 类型都支持时检查。
- 设备是冷启动、
adb reboot,还是 OTA 后第一次启动。 metadata.json是否记录按键/重启方式、boot id、ready 标准、trace start/end、设备 build 和采集者权限。
分析顺序建议固定:init/service 启动、zygote、system_server、PackageManager/ActivityTaskManager、SurfaceFlinger、Launcher、首帧/可输入 ready 点。报告里要写清 ready 标准,否则“开机慢 3 秒”很容易变成跨团队争论。
若要读取崩溃重启前的末段 ftrace,可另看 Tracing across reboot 的 linux.frozen_ftrace。它依赖内核侧预置持久环形缓冲,和本文“在下一次 Android 启动时自动录制”的 boottrace 是不同方案。
三种现场长 Trace 模式
Perfetto 的现场长 Trace 可以按这三种模式设计:
| 模式 | 行为 | 适合场景 | 风险 |
|---|---|---|---|
| Ring Buffer + STOP trigger | 一直循环记录最近窗口,异常发生后停止 | 掉帧、ANR 前兆、音频 underrun | Buffer 太小会覆盖根因;trigger 未命中就没有事故现场 |
write_into_file 长录制 |
周期把 Buffer 写到文件 | 几十分钟到数小时趋势 | I/O 开销、文件过大 |
--clone-by-name snapshot |
原始 session 继续跑,按需克隆当前窗口 | 调参、温控、电源策略实验 | 需要设备端 perfetto 支持 --clone-by-name,以 perfetto --help / --version 为准;clone 服务能力通常从 Android 14 提供,按名称克隆还需要 v49+ CLI 或对应厂商合入 |
选模式前,我会先问事故发生前的证据需要留多久:几十秒的偶发卡顿用 Ring Buffer,几小时的趋势问题就得考虑周期写文件。模式定了,再决定数据源。
Ring Buffer 的基线配置
下面这份配置用于 UI 偶发卡顿:trace 启动后立刻记录,Ring Buffer 只保留最近窗口;当 App、平台服务或测试 harness 检测到慢帧并激活 app_ui_jank trigger 后,Perfetto 再记录 1 秒并停止。
这份配置假设第 13 篇讲过的 App 侧业务 marker 和 trigger emitter 已经接入。trigger_config 不会自己根据 FrameTimeline 自动触发;没有 emitter,session 只会等到 trigger_timeout_ms 清理,不能当成“末尾窗口兜底”。
1 | unique_session_name: "ui_jank_flight_recorder" |
这里放了两个 Buffer:高频 ftrace/atrace 进入大 Buffer,FrameTimeline、process stats、App Track Event 进入小的语义 Buffer。原因在于:图形问题里,如果 sched 事件保住了、FrameTimeline、App marker 或进程描述却被覆盖,仍然无法判断是 App、SurfaceFlinger、BufferQueue 还是系统调度导致卡顿。
producer_name_regex 用来限定能激活 trigger 的 producer。正则要和实际 emitter producer 名称一致;如果由测试 harness 代理触发,就把 harness producer 加进白名单,或者为 harness 单独开 trigger 名称。
buffer_size_kb=4096 是每CPU预算,8核设备仅这一层就可能约32 MiB,另加shared memory和72 MiB中央buffer。buffer_size_lower_bound 会限制向下调整,但不保证实际配置始终等于请求值。drain_period_ms 控制周期读取,调小通常增加唤醒;当前250ms不是对所有设备都优于默认值。先查实际设置、setup errors和开销,再调参。
FrameTimeline 需要 Android 12 或更高版本。它不是 trigger emitter,只负责在 trace 里提供 app frame、SurfaceFlinger frame、jank_type、present_type、on_time_finish 和 app-SF flow 等事实。atrace_apps 必须限定目标包名,不要把 atrace_apps: "*" 当成现场默认方案。
Ring Buffer 能保留多久,不由 trigger_timeout_ms 决定,而由数据写入速率和 Buffer 大小决定。估算方式仍然是第 12 篇那条:单buffer保留窗口秒数 ≈ 容量MiB / 写入该buffer的MiB/s。
对 ftrace 还要再看三层 buffer:kernel per-CPU ftrace buffer、producer shared memory、Perfetto central buffer。central buffer 变大只能延长最终保留窗口,救不了 kernel buffer 被 traced_probes 来不及 drain 时的早期丢事件。
现场长 Trace 调优时才考虑 ftrace_config.buffer_size_kb、buffer_size_lower_bound、drain_period_ms、drain_buffer_percent;这些字段要先在短 Trace 里验证开销和设备兼容性。drain_buffer_percent 的当前语义从 Perfetto v48 引入,官方 proto 注释注明 Linux 内核低于 6.9 时不生效;不要把它当作旧内核上替代 drain_period_ms 的通用开关。
若一个64 MiB buffer的实际写入率为2 MiB/s,理想稳态窗口约32秒;增加写入同一buffer的事件会缩短它。其他buffer要分别计算,不能把不同buffer的数据源速率混在分母里。STOP触发后的1秒也继续占用Ring容量,会进一步覆盖前面的数据;要保留触发前窗口,需同时预算尾窗和停机/flush延迟。未命中STOP不返回数据,人工兜底应激活允许的人工trigger,或使用独立且已验证的snapshot会话。
UI jank preset 抓完后,先确认 FrameTimeline 真的存在:
1 | SELECT 'expected' AS table_name, COUNT(*) AS rows |
再按 process 表确认 App 与 SurfaceFlinger 的 upid,把下列 NULL 替换为这两个进程实例和真实问题窗口的整数ns起止时间。查询保留零行计数和可能与窗口重叠的未闭合帧,不用同名进程或模糊cmdline混合实例;它只检查记录是否存在,不证明目标layer、因果关系或连续覆盖:
1 | WITH target_window(start_ns, end_ns) AS ( |
如果怀疑 hardirq、softirq 或 kworker 抢 CPU,不要把这些事件放进默认长 Trace。先做短窗口专项 preset,再按结果决定是否进入现场方案:
以下是数据源片段,应并入带明确duration_ms的完整配置;这里不包含独立启动命令。
1 | data_sources { |
长录制要周期写文件
几小时问题不能只靠内存Buffer。下面可保存为field.pbtxt,采集CPU频率、thermal节点和系统内存的低频趋势,供后面的后台/停止示例使用;它不包含sched或帧事件。专项加入高频数据源后,要重新测量文件增长与扰动:
1 | unique_session_name: "field_trends" |
duration_ms 默认不计算系统 suspend 时间。亮灭屏、待机、车机休眠这类按 wall-clock 看的现场问题,应该考虑 prefer_suspend_clock_for_duration: true;它也会影响 trigger stop_delay_ms 的时间语义。
下面大小按二进制单位计算:2147483648 bytes为2 GiB。若实际文件增长为1–2 MiB/s,约17–34分钟就会碰到上限,早于1小时duration。官方调度采集速率只是参考;容量预算要用当前preset的实测峰值/平均值,不能假定缩短写周期会减少总文件量。
log、syscall、page fault与宽泛的业务事件可能显著增加数据量。v58.3 的 write_into_file + AUTO 在写周期大于5秒时于每次写前flush;因此本例10秒写周期不会再按 flush_period_ms:30000 执行。若明确需要手动周期,支持该字段的版本可选 WRITE_FLUSH_DISABLED 配合 flush_period_ms;不能把旧文档10–30秒的经验值当当前AUTO规则。
后台运行和安全停止
现场测试经常会断USB。v58.3 的 --background-wait 最多等30秒获取启动确认,成功退出码为0;先打印PID不代表确认已经成功。它确认的是启动协议,不保证所有预期事件或晚注册producer已就绪;测试动作应等成功返回,采集后仍要核对数据源与窗口。超时后后台子进程可能还在,先查session状态,不能立刻重复启动。
Android 12 及以上设备可将配置放进 /data/misc/perfetto-configs,再启动后台 trace;具体写入权限仍以设备为准:
1 | adb push field.pbtxt /data/misc/perfetto-configs/field.pbtxt || exit 1 |
如果 Android 12–17 的目标设备无法使用上述配置路径,也可以从 stdin 传入配置。生产 M2M 工具链更应该用审核过的 preset 或 binary TraceConfig,而不是让服务端下发任意文本配置:
1 | PID=$(adb shell perfetto --background-wait --txt \ |
两种启动方式二选一,并在同一主机shell中保存本轮PID、boot id和进程启动tick。跨终端时由工具把这些身份字段存入case metadata并恢复,不能只拿一个旧PID去kill。停止时别发完信号就马上 adb pull,Perfetto 还要写完尾部数据。先核对身份,发 SIGINT 后等待同一进程退出和文件稳定,再 pull;此处是非 detached 的示例。
1 | case "$PID" in |
上段应紧接启动成功后执行。运行场景结束后,再执行以下停止/拉取步骤;若进程已自动结束,也要通过日志与stats区分正常结束和异常退出。
1 | CURRENT_BOOT_ID=$(adb shell cat /proc/sys/kernel/random/boot_id) || exit 1 |
可用inotifyd时,先安装监听再发停止信号,以免漏掉close_write。大小稳定不是close/fsync证明;PID身份检查与kill之间也不是原子操作。长期自动化应由拥有session的服务管理生命周期;身份变更、超时或无法读进程状态时返回待核查,不能默认完整或去killall。
trigger 怎么用
Perfetto trigger 的价值是权限隔离:有权限的一方提前声明 trigger 名称和行为;普通 App 或系统组件只报告“事件发生了”,不能决定抓什么、抓多大、传哪里。
现场方案要把 trigger emitter 写清楚。UI jank 可以由 App 侧 JankStats / FrameMetrics / 自研阈值检测后激活 app_ui_jank,也可以由平台服务或测试 harness 代理激活。无论哪条路,都要做去重和限流,并在 metadata 里记录 trigger source、触发时刻和判断阈值。
App emitter 协议建议固定成一条 JSON 事件,并同时写入同 event_id 的 Track Event:
1 | { |
服务端或分析脚本用 event_id 和时间窗口把外部 trigger 记录、trace 内 Track Event、FrameTimeline 慢帧对上。对不上时,这份 Trace 只能当系统侧上下文,不能直接归因到页面或业务动作。
JSON中的sample_decision=record只是App的决策,不是service已接受trigger。event_id标识业务事件,也不是FrameTimeline的frame token;需要明确目标进程、layer与关联规则。CLOCK_BOOTTIME只表示本例已完成时间转换,不能直接把JankStats原始起点塞进elapsed字段。
测试环境可以用下面两种 shell 方法激活 trigger,但上面的 preset 设置了 producer_name_regex: "com\\.example\\.app":shell 工具的 producer 名若不匹配,trigger 会被过滤。测试时应使用匹配的 App producer 激活,或在仅用于实验室的配置里调整这项过滤,不能把命令执行成功当成 trigger 已命中。
1 | adb shell /system/bin/trigger_perfetto app_ui_jank |
也可以用一段只包含 activate_triggers 的配置激活同名 trigger:
1 | echo 'activate_triggers: "app_ui_jank"' | \ |
STOP trigger 适合“根因在触发之前”的问题,比如慢帧、ANR 前兆、音频 underrun。START trigger 适合“事件发生后还要继续观察”的问题,比如温度进入 hot 状态后继续抓 10 秒。
使用 START trigger 时,不要再同时配置普通 duration_ms;触发窗口由 trigger_config 管。
只有确认session启动成功、达到trigger_timeout_ms且没有接受到触发,才能记trigger_matched=false:START/STOP此时不返回trace数据,文件可能为空或不存在。空文件本身也可能来自权限、配置、进程或I/O失败,原因未查清就保留unknown,不能直接归为“没有发生问题”。触发被接受后按stop_delay_ms结束;下一轮需新case id/文件并重新启动,重启间隙也要计入覆盖率。
snapshot 适合调参
有些场景不想停止原 Trace,只想每隔几秒拿一张当前窗口的快照,例如调 CPU policy、thermal 参数、电源策略。--clone-by-name 这个命令行入口是 Perfetto v49.0 加入的;session 克隆能力本身也要 Android 14+ 的平台侧支持或厂商合入,最终以 adb shell perfetto --help / --version 为准。
下面给出可独立保存为thermal.pbtxt的10分钟示例,按秒轮询CPU频率和thermal节点;字段与节点读取仍需设备支持。它不启用STOP trigger,也不周期写文件,因此snapshot读取的是当前Ring窗口:
1 | unique_session_name: "thermal_snapshot" |
先确认没有同名session,再启动;成功后按需克隆,原session在10分钟到期前继续运行。每次clone输出应使用新的文件名。以下主机命令需要CLI支持--clone-by-name:
1 | adb shell perfetto --query |
启动成功后运行待测场景,再在需要保留窗口时执行下面两条命令。
1 | SNAPSHOT_FILE="thermal-$(date +%Y%m%d-%H%M%S).pftrace" |
clone也会请求flush并消耗额外缓冲/读取资源,不是零扰动快照。过密snapshot可能彼此重叠,不能直接拼成无缝历史;它也无法恢复已被Ring覆盖的事件。要做连续趋势,仍需核对每次窗口的重叠与缺口。
detached mode 少用
--detach 会让 tracing session 脱离 perfetto 命令生命周期,由 traced 服务继续持有 session。官方文档明确不推荐常规使用,因为它容易泄漏 session,让设备长时间处在 tracing 状态。
必须用 detached mode 时,配置里要打开 write_into_file,并准备检查和停止命令:
1 | adb shell perfetto --detach=field_session --txt \ |
工程脚本里要有兜底清理:启动前检查旧 session,测试结束后停止 session,超过 TTL 自动停止。
attach/detach的key不是unique_session_name,重新attach还要求同一Unix UID;先adb root再换shell可能改变身份。--is_detached返回0表示可attach、2表示找不到,1是错误,不能把通信失败当不存在。field.pbtxt必须是有数据源、write_into_file和duration_ms的完整配置。
Bugreport 是现场兜底入口
现场问题经常是用户、测试或运维先碰到,随后触发 bugreport。bugreport 保存的是符合条件且当时仍存在的 session。下面是要合并到完整配置的session字段,不是独立配置;例如合并到上面的thermal.pbtxt时,替换原unique_session_name,保留数据源和duration,重新启动后才生效:
1 | unique_session_name: "field_thermal_bugreport" |
bugreport_score > 0 才会成为 bugreport 候选;分数越高,越优先被保存。bugreport_filename 从 Android 15 / Perfetto v42 起可用于 --save-all-for-bugreport 的可读文件名,旧版本会按默认名字保存。它和普通 -o /path/trace.perfetto-trace、--upload 是不同路径:前者服务 bugreport,后两者服务本次命令输出或 framework reporting。
研发或平台脚本可以用这两条命令验证 bugreport 行为:
1 | adb shell perfetto --save-for-bugreport |
Android 12/13 上,bugreport 保存会取走 trace 内容并提前停止 session;Android 14 及以上版本会创建只读 snapshot,原 session 可以继续运行。报告里要写清 Android 版本和验证命令输出,不要把 bugreport 合包当成普通后台 trace 的等价路径。
两条save命令是按设备能力选择的不同入口,不要求连续执行;--save-for-bugreport选最高分,支持的--save-all-for-bugreport保存全部符合条件者。保存到设备bugreport目录不等于已经生成或上传bugreport ZIP。正的bugreport_score还让session具备被其他UID克隆的资格,应按可进入bugreport的数据范围设计。
现场证据包里应该有什么
只拿 .perfetto-trace 不够。现场证据包至少要能回答“这是什么场景、什么时候触发、文件是否完整”。
1 | case-20260504-153012/ |
metadata.json 建议包含这些字段:
1 | { |
这里的 metadata 不替代 trace,它给排查者定位问题窗口、过滤版本、判断环境差异。第 13 篇已经讲过 App 侧如何补页面、业务阶段和用户操作;现场证据包里的 metadata 要负责把这些业务 marker 对上。
summary.json 则是自动化入口,字段要能直接驱动 triage、上传和留存:
1 | { |
上述JSON是已完成独立验收后的假设记录:20秒前窗、约1秒尾窗,不是默认值或从文件大小推导的结果。trigger_matched、file_complete、usable_metrics与upload_allowed分别需要证据;未核实保留null/unknown,不能自动填true。最早和最晚事件包围窗口仍不证明中间完整。A/B/C/D只是报告策略,B的核心判断可用需独立证明,不能仅凭loss数量较小。
长Trace要写清clock domain。Android上的ftrace常用CLOCK_BOOTTIME;日志原始wall time进入解析器后可能已归一,不能再手动重复加offset。JankStats/FrameMetrics来源也不能只改字段名就当elapsed realtime。外部JSON不由Trace Processor自动转换,需要同一次开机的时钟配对与trace内marker核对,wall time还可能受校时影响。
外部 metadata 至少同时记录 elapsed realtime、wall time 和 boot id;更稳的做法是把 trigger 本身也写成 trace 内 Track Event。分析前如果看到 clock sync failure 或 invalid clock snapshot,跨数据源同步要降级处理。
裁剪优先发生在采集侧
Perfetto Trace 里有增量状态、track descriptor、stats、metadata。事后硬切二进制文件,很容易破坏解析。推荐顺序是:
- 用 Ring Buffer 控制“只保留最近窗口”。
- 用
stop_delay_ms控制触发后保留多久。 - 在write_into_file模式用max_file_size_bytes限制文件增长;触及上限会结束录制,可能早于问题发生,不能用于离线裁剪。
- 上传完整问题窗口的原始 Trace。
- 服务端生成 summary、截图、SQL 结果,作为轻量索引。
如果必须离线裁剪,工具要按 TracePacket 重写,并保留必要 descriptor 和 stats。不要用 dd、文本截断、随机切 protobuf 字节流。
上传和清理策略
现场长 Trace 接近真实用户环境,上传策略不能只考虑研发便利:
- 默认只在 Wi-Fi、充电或用户授权条件下上传。
- 文件超过阈值时先上传 summary,原始 trace 留在本地等待人工导出。
- log 按 tag 白名单采集,并在上传前脱敏。
- trace 文件设置 TTL,例如 3 天自动清理。
- trigger 同时使用 TraceConfig 的
max_per_24_h和客户端限流。 - 上传前跑
stats,把 data loss 写进 metadata。 - 不允许服务端下发任意 text proto 配置到用户设备,只允许选择审核过的 preset。
这些限制会减少临时调参空间,但能控制上传、隐私和稳定性风险。
分析前固定检查
拿到现场文件后,先确认 Trace 覆盖了触发点前后的目标时间,再查 stats 中与该场景相关的数据源。录制进程活了几小时,不等于文件里保留了几小时的有效事件。
1 | SELECT trace_start() AS trace_start_ns, trace_end() AS trace_end_ns, |
如果时长不符合预期,先查 trigger_timeout_ms、max_file_size_bytes、后台进程是否被杀、文件是否还没 close、duration_ms 是否按 suspend 语义计算。数据不完整时,报告要写明哪些判断不能下。
再跑全局质量检查。stats 体检的完整查询和“常见项 → 处置决策”的映射表第 12 篇已经给过,把那条 SQL 放进分析脚本开头直接复用即可,这里不重复。现场长 Trace 要在它之上多做两层。
先是 per-buffer 检查。traced_buf_* 的 idx 对应 buffer 下标;下面同时列出的全局 flush/config 项不能按 buffer 编号解释:
1 | SELECT name, idx, severity, source, value |
RING_BUFFER 下的 traced_buf_chunks_overwritten 不一定是错误,它通常表示窗口外的旧数据被覆盖。要单独看它是否把 trigger 前根因覆盖掉:
1 | SELECT name, idx, severity, source, value |
如果现场打开 ftrace,还要记录 ftrace clock、可用事件和 setup error。跨 trace 比较时,clock 或事件集不同,会直接影响 sched/freq 结论可信度:
1 | adb shell cat /sys/kernel/tracing/trace_clock |
把偶发问题变成证据
一次偶发问题的证据包至少要能回答:触发点在哪、触发前事件保留了多久、文件是否完成写入、哪些数据源发生丢失。缺任何一项,报告都应缩小结论范围。App 侧 Track Event 可标记业务触发点,系统 Trace 再解释触发前后发生了什么。
参考文档
- Trace configuration
- Buffers and dataflow
- Tracing in Background
- Running perfetto in detached mode
- Perfetto command-line reference
- TraceConfig proto reference
- Android boot tracing
- FrameTimeline
- ATrace
- Android Log
- Clock synchronization
- Trace Processor Stats
原文源码基线为b23c67be(2026-09-19),保留如下。本次另核对 v58.3 init规则、CLI实现、TraceConfig、service写入/flush 与 v49变更记录。
关于我 && 博客
欢迎关注 Android Performance。