EN

Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测

字数统计: 10.6k阅读时长: 47 min
2026/05/04
loading

在 Perfetto UI 里框出问题窗口,看主线程、RenderThread 和 CPU 状态,再截几张图,单次定位很方便。换一份 Trace 或换一台设备,截图里的判断就难以按同一口径重算。我更关心的是:下次拿到同一类问题,还能不能算出可复查的数字。

PerfettoSQL 与 Trace Processor 可以把时间窗口、线程身份和耗时口径写进查询,再让 Python 对多份 Trace 执行同一段 SQL。这样复测版本时,能回到每份原始 Trace 核对数字。

下面从一条手工判断出发,逐步得到可批量执行的查询和结构化输出。示例代码需要替换目标进程、时间窗口和采集条件后再用于自己的场景。

版本说明(2026-10 核查):本文以 Perfetto v58.3 源码中的 SQL/CLI 合同和 Python perfetto==0.58.2 API 为核对基线。get.perfetto.dev 是滚动下载入口,本次取得的 wrapper 内置原生 v58.2;源码标签、Python 包版本和实际二进制版本需要分别记录。运行前看 --version 与相应子命令 --help,不要把旧版不支持的参数解释为 Trace 数据问题。

Perfetto 系列文章

  1. Android Perfetto 系列目录
  2. Android Perfetto 系列 1:Perfetto 工具简介
  3. Android Perfetto 系列 2:Perfetto Trace 抓取
  4. Android Perfetto 系列 3:熟悉 Perfetto View
  5. Android Perfetto 系列 4:使用命令行在本地打开超大 Trace
  6. Android Perfetto 系列 5:Android App 基于 Choreographer 的渲染流程
  7. Android Perfetto 系列 6:为什么是 120Hz?高刷新率的优势与挑战
  8. Android Perfetto 系列 7:MainThread 和 RenderThread 解读
  9. Android Perfetto 系列 8:深入理解 Vsync 机制与性能分析
  10. Android Perfetto 系列 9:CPU 信息解读
  11. Android Perfetto 系列 10:Binder 调度与锁竞争
  12. Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测
  13. Android Perfetto 系列 12:Trace 数据流与丢失排查
  14. Android Perfetto 系列 13:Perfetto SDK、Track Event 与 App 现场 Trace
  15. Android Perfetto 系列 14:heapprofd 与内存 Profiling
  16. Android Perfetto 系列 15:Boot Trace、长时间现场 Trace 与偶发问题抓取
  17. Android Perfetto 系列 16:GPU、Power Counters 与硬件瓶颈分析
  18. Android Perfetto 系列 17:专项场景自动化、问题清单与平台体系
  19. Android Perfetto 系列 18:响应速度实战,从输入事件到首帧反馈
  20. 视频(B站) - Android Perfetto 基础和案例分享
  21. 视频(B站) - Android Perfetto 分享 - 出图类型分享:AOSP、WebView、Flutter + OEM 系统优化分享

从截图结论到可复查查询

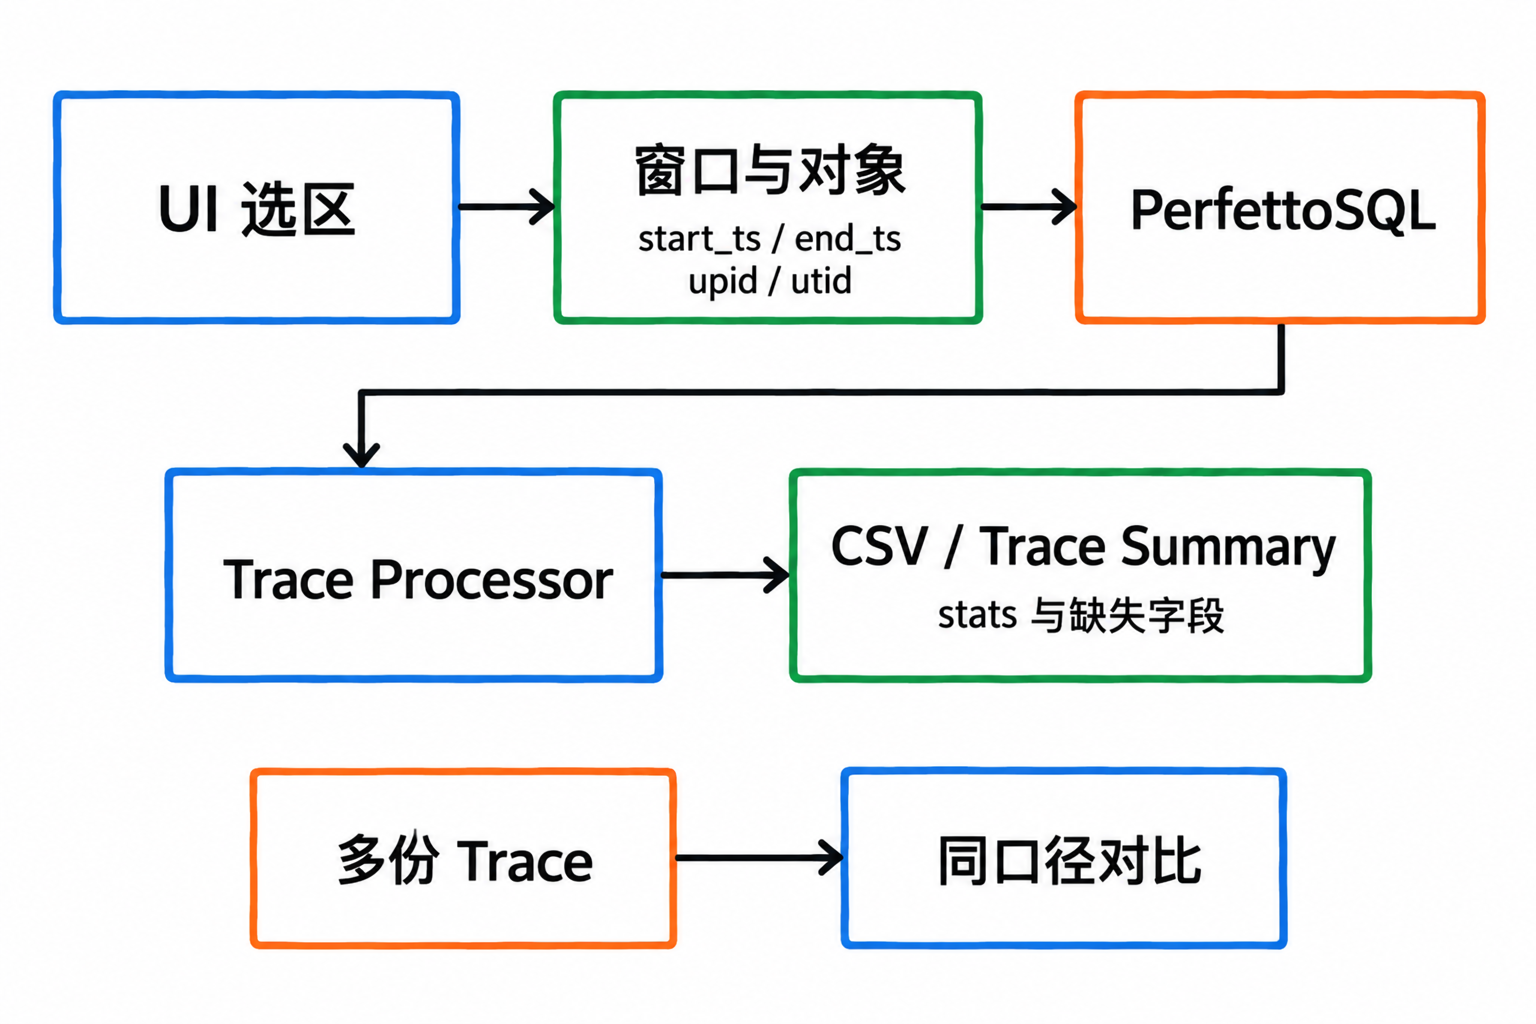
第 3 篇的 UI 操作负责发现问题窗口,第 9、10 篇的 CPU 与 Binder 查询负责观察具体信号。这里把窗口、对象、质量条件和输出字段一起固定,才能在下一份 Trace 上复用同一口径。

直接读这篇也可以,但最好先准备四样东西:一份 .perfetto-trace,目标 App 包名,UI 里能框出的目标时间窗口,以及本机可运行的 trace_processor。后面的 SQL 都围绕这四个输入展开。

从手工判断到自动化报告,可以拆成这几步:

1
2
3
4
5
Perfetto UI 建立判断
-> PerfettoSQL 把判断写成查询
-> Trace Processor 在命令行执行查询
-> Python 批量处理多份 Trace
-> Trace Summary 或自定义报告输出稳定结果

把 UI 判断变成可复跑查询

示意图:先固定窗口、对象与质量条件,再把 SQL 结果用于批量对比。

工程上常见的使用方式有三类:

  • 临时排查:UI 里发现某段可疑,再用 SQL 查成时间、线程、进程、持续时间和原始证据。
  • 专项分析:同一类问题要看几十份 Trace,例如滑动卡顿、点击响应、Camera 打开慢,输出同一组诊断字段。
  • 回归检测:每个版本都跑同一组查询,把 before/after 结果写进报告或看板。

UI 依然很有价值。SQL 的职责是把 UI 里的判断保存下来,方便复查和批量比较。

Trace Processor 是什么

Trace Processor 是 Perfetto 的分析引擎。它负责把 Perfetto protobuf Trace、Chrome JSON trace 及其他受支持格式解析成统一的 SQL 表。Perfetto UI 里的很多轨道,也是基于这些表和视图查询出来的。

系列第 04 篇用过 trace_processor_shell --httpd 打开大 Trace。官方文档现在把面向用户的命令写成 trace_processor:下载下来的文件是一个 Python 包装脚本,首次运行时会按平台拉取并缓存原生 Trace Processor 可执行文件。

先把命令装好。这段 macOS/Linux shell 命令下载 wrapper、显示版本并进入交互环境;需要 Python 3 和首次下载原生工具的网络访问。

1
2
3
4
curl -fLO https://get.perfetto.dev/trace_processor
chmod +x ./trace_processor
./trace_processor --version
./trace_processor interactive trace.perfetto-trace

旧文档和旧脚本里经常会看到直接运行 ./trace_processor trace.perfetto-trace 的写法。这种默认交互模式目前仍然可用,但新脚本建议写成子命令,把用途表达清楚。

命令行批处理时,重点看 query。它不会打开 UI,而是加载 Trace、执行 SQL、把结果打印出来:

1
2
./trace_processor query trace.perfetto-trace \
"SELECT ts, dur, name FROM slice LIMIT 5;"

大 Trace 仍然可以让 UI 使用本地 Trace Processor,减轻浏览器解析压力。本文核对版本的子命令写法是:

1
./trace_processor server http trace.perfetto-trace

这个命令启动本机 HTTP RPC 服务,默认监听 9001 端口。打开 Perfetto UI 时,它会探测本机服务并询问是否使用外部 Trace Processor;选择已加载的 Trace 后,解析工作由本机进程完成。

trace_processor_shell --httpd 仍是兼容入口。新脚本统一用 trace_processor server http,方便和官方命令行文档对照。

UI 连接后,SQL/解析在本机进程,时间线渲染仍在浏览器。连接既有 HTTP RPC 服务意味着共享它已经加载的状态;给 Python API 同时传 addr 和 trace 还可能向该服务加载数据,不适合当成无副作用的查询。独立批处理用自己创建并关闭的 Trace Processor。

把 Trace 当成几张表

PerfettoSQL 是 Trace Processor 提供的 SQL 方言。入门阶段不用背完整 schema,先从几类常用表开始:

类型 常见表 用途
时间片 slice 一段有开始时间和持续时间的事件,例如 ATrace、Track Event、部分导入或派生出来的时间片
计数器 counter、counter_track 随时间变化的数值,例如 CPU 频率、内存、功耗、业务计数
线程与进程 thread、process 线程名、进程名、tid、pid、utid、upid
轨道 track、thread_track、process_track slice/counter 等事件的归属关系;UI 可视轨道不一定和这些表一一对应
调度状态 thread_state、sched thread_state 记录线程状态,sched 记录线程实际占用 CPU 的 Running 区间
CPU 采样 perf_sample、cpu_profile_stack_sample CPU profiling 的采样事实表
调用栈维表 stack_profile_* callsite、frame、mapping 等栈信息,通常要和采样表一起查
完整性 stats 数据丢失、解析异常、buffer 问题等采集质量信息

这里最容易混淆的是 tid/pid 与 utid/upid。系统里的 tid/pid 会复用,同一份 Trace 里也可能出现多个同名线程。Trace Processor 用 utid/upid 表示本次 Trace 内唯一的线程和进程实体。写脚本时优先用 utid/upid,不要只靠线程名。

时间列的单位也要尽早记住:ts 和 dur 通常按纳秒理解。转换有两个方向,精度不一样:time.conversion 的 time_from_ms() 是乘法,写阈值时精确,dur > time_from_ms(5) 比裸写 5e6 更好读;time_to_ms() 是整数除法($nanos / (1000 * 1000),返回 LONG),会把 1.6ms 截断成 1。所以它适合整毫秒展示或粗分桶;保留原始纳秒用于计算,展示耗时可写成 ROUND(dur / 1e6, 3);三位小数仍会舍入亚微秒差异,不能再拿展示值判定整窗覆盖。counter.value 没有统一单位,必须结合 counter_track、具体模块和采集配置解释;CPU 频率、内存、power rail、业务计数不能直接按同一套 AVG 口径比较。

还有一类表要特别分清:thread_slice 这类名字来自 slices.with_context 标准库模块提供的视图,不是原始 schema 表。它提前把 slice、track、thread、process 关联好,所以才能直接查 process_name、thread_name、is_main_thread。复制这类查询时,前面的 INCLUDE PERFETTO MODULE ... 不能漏。

SQL 报错先分三类,再动手改:INCLUDE PERFETTO MODULE 失败或提示模块不存在,通常是本地 Trace Processor 版本太旧、标准库还没有这个模块,先跑 ./trace_processor --version 再决定升级;no such table / no such column 优先怀疑漏了 INCLUDE 或 schema 演进,用 PRAGMA table_info(table_name); 确认列名;查询成功但返回 0 行是第三种情况——数据源没采到或窗口选错,这不是语法问题,要回到 stats 和采集配置。三类的处理路径完全不同,不要一上来就改 SQL 本身。

调度状态也依赖采集配置。要分析 thread_state、Running、Runnable 和 wakeup,Trace 里至少要有 ftrace sched 相关事件,尤其是 sched/sched_switch、sched/sched_wakeup、sched/sched_waking。只看 Running 主要依赖 switch;要解释 wakeup 与 Runnable 的关系,还需要 wakeup/waking。缺这些事件时,只能写“证据不足”,不能写“没有调度问题”。

CPU profiling 也有类似边界。perf_sample、cpu_profile_stack_sample 是采样事实,不是执行全量记录;采样频率、采样窗口、unwind、symbolization 和 lost sample 统计都会影响结论。没有有效采样记录时,应写“未获得可用 CPU profile”,再区分未采集、未命中目标、权限或解析问题,不能直接写“没有 CPU 热点”。

一次完整分析怎么写成 SQL

用一个常见场景串起来:UI 里发现某个目标窗口内主线程有明显停顿,现在要把这次判断写成可复查的查询。这个窗口可以来自 UI 选区、Track Event 标记、输入事件,或者某个 frame/CUJ 的起止时间。

采集质量先决定结论语气

写任何结论前,先看采集质量。stats 里既有普通计数,也有错误和数据丢失。做自动化门禁时,不要把所有非零项都当成失败;先把会直接限制结论的项列出来,再按数据源决定是复抓、降级,还是只影响某一类指标。

官方统计项表里的类型会写成 kError、kDataLoss、kInfo,但 stats.severity 的查询值是小写字符串。这条查询保留原始 name/idx/severity/source/value,同时给出影响范围提示;不要在通用入口里把所有 error 或 data_loss 都写成整份 Trace fatal。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
SELECT
name,
idx,
severity,
source,
value,
CASE
WHEN severity = 'data_loss' AND LOWER(name) LIKE '%ftrace%' THEN 'sched_or_ftrace_degraded'
WHEN LOWER(name) LIKE '%frame_timeline%' THEN 'frame_timeline_degraded'
WHEN LOWER(name) LIKE '%track_event%' THEN 'track_event_degraded'
WHEN severity IN ('error', 'data_loss') THEN 'metric_dependency_check_required'
ELSE 'configuration_or_parser_context'
END AS metric_impact_hint
FROM stats
WHERE value != 0
AND (
severity IN ('error', 'data_loss')
OR LOWER(name) LIKE '%loss%'
OR LOWER(name) LIKE '%drop%'
OR LOWER(name) LIKE '%parse%'
OR name IN ('ftrace_setup_errors', 'traced_buf_chunks_overwritten',
'traced_buf_chunks_discarded', 'traced_flushes_failed',
'traced_final_flush_failed')
)
ORDER BY severity, source, name, idx;

如果结果里出现 data_loss、parser error、buffer overrun、packet loss 相关内容,后面的判断都要降低语气。ftrace loss 会直接影响 sched/thread_state/wakeup 判断,但不一定让 App Track Event 全部不可用;FrameTimeline 缺失会影响帧指标,但不一定影响 Binder 或内存查询。报告里要保留 stats 明细,再由每个指标决定复抓、剔除或降级。

需要做采集配置优化时,再放宽到 value != 0 查看完整 stats,因为 buffer 大小、写入量、ftrace 计数这类 info 项也能解释为什么丢。第 12 篇会专门讲完整的数据丢失分类;这一篇先把它放进自动化入口。

如果要做帧指标,还要额外检查 FrameTimeline 数据是否存在。长 slice 不是慢帧口径,FrameTimeline 的 actual/expected frame、jank type、overrun 才能回答帧层面的回归问题:

1
2
3
4
5
SELECT 'actual' AS table_name, COUNT(*) AS row_count
FROM actual_frame_timeline_slice
UNION ALL
SELECT 'expected' AS table_name, COUNT(*) AS row_count
FROM expected_frame_timeline_slice;

这些表存在且查询成功时返回两行;其中 row_count = 0 不一定是 Trace 坏了,可能是 Android 版本、采集配置或场景不支持。需要 actual/expected 配对的指标此时不可用;只依赖单侧数据的统计需另定口径,不能用 RenderThread 长 slice 补成慢帧结论。

先把目标窗口固定下来

目标窗口不要停留在“UI 里框了一段”。脚本需要明确的 start_ts/end_ts,后面的长切片、调度状态、帧指标都要引用同一个窗口。最稳的来源是 App 自己打的 Trace.beginSection() 或 Track Event 标记:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
INCLUDE PERFETTO MODULE slices.with_context;
INCLUDE PERFETTO MODULE time.conversion;

SELECT
'app_marker' AS window_source,
name AS window_name,
upid,
utid,
ts AS start_ts,
ts + dur AS end_ts,
time_to_ms(ts) AS start_ms,
time_to_ms(ts + dur) AS end_ms,
ROUND(dur / 1e6, 3) AS duration_ms,
process_name,
thread_name
FROM thread_slice
WHERE process_name = 'com.example.app'
AND name = 'feed_scroll'
AND dur > 0
ORDER BY ts
LIMIT 10;

如果窗口来自 frame、CUJ、输入事件或 UI 选区,也要保留原始整数纳秒。下面先限定本 Trace 中已确认的目标 upid,再列候选 actual frame;把 NULL 替换为已查得的整数,勿照抄其他 Trace 的 ID。无行可能是没填 ID、过滤不匹配、没有闭合帧或缺数据,应先记录 no_valid_target_frames 并查原因,不能一律归为全 Trace 缺 FrameTimeline。App frame 的生命周期也不自动等于输入到屏幕响应时间。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
INCLUDE PERFETTO MODULE time.conversion;

WITH target_process(upid) AS (VALUES (NULL))
SELECT
'frame_timeline' AS window_source,
name AS window_name,
id AS frame_slice_id,
upid,
ts AS start_ts,
ts + dur AS end_ts,
time_to_ms(ts) AS start_ms,
time_to_ms(ts + dur) AS end_ms,
ROUND(dur / 1e6, 3) AS duration_ms
FROM actual_frame_timeline_slice
WHERE upid = (SELECT upid FROM target_process)
AND dur > 0
ORDER BY dur DESC
LIMIT 10;

后面的示例为了缩短篇幅,仍然用 target_window CTE 写死一个窗口。实际脚本里应从 metadata 或前置查询传入 window_source/window_name/start_ts/end_ts,并把这些字段写进报告。

所有窗口按半开区间 [start_ts, end_ts) 处理。UI 的相对显示时间需先转换到 Trace 原始时间域;不同文件的同一个数值通常不代表同一业务阶段。下面长切片和调度查询的 target_process 也需要逐 Trace 填入已确认的 upid,否则返回空行或零计数只表示占位参数未设置。

不要只靠 main 找线程

很多示例喜欢直接写 thread.name = 'main'。这在单个 App 里看起来方便,放到系统 Trace 里就容易误伤,因为每个 App 都可能有一个 main。先把目标进程里的线程列出来,目的是确认 upid/utid:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
INCLUDE PERFETTO MODULE time.conversion;

WITH candidate_processes AS (
SELECT
p.name AS process_name,
p.upid,
p.pid,
COUNT(th.utid) AS thread_count,
MAX(th.is_main_thread) AS has_main_thread,
time_to_ms(MIN(th.start_ts)) AS first_thread_start_ms
FROM process p
JOIN thread th USING (upid)
WHERE (p.name = 'com.example.app' OR p.name GLOB 'com.example.app:*')
GROUP BY p.name, p.upid, p.pid
)
SELECT
cp.process_name,
cp.upid,
cp.pid,
cp.thread_count,
cp.has_main_thread,
cp.first_thread_start_ms,
th.name AS thread_name,
th.utid,
th.tid,
th.is_main_thread
FROM thread th
JOIN candidate_processes cp USING (upid)
ORDER BY cp.process_name, th.is_main_thread DESC, th.name;

first_thread_start_ms 为 NULL 表示这份 Trace 没有记录到线程的创建时间,常见于线程在录制开始前已经存在;不能把 NULL 当成 0,也不能据此判断线程不存在。

把 com.example.app 换成目标完整进程名;查询额外接受冒号分隔的子进程,避免误中 com.example.application。多进程 App 可能有 :remote、:push;WebView sandbox 或 isolated process 未必遵循这个命名规则,需另查归属。UI 渲染问题优先选承载 Activity、FrameTimeline 或 App marker 的进程,跨进程业务路径就保留多个 upid,报告里不要合并成一个“App 总耗时”。

长切片只能列可疑点

PerfettoSQL 标准库已经提供了预先关联好的视图,能少写很多容易错的 JOIN。这段 SQL 引入 slices.with_context 和 time.conversion,查询目标窗口内超过 5ms 的线程切片。

target_window 里的时间是 Trace 时间戳,单位仍然是纳秒。实际使用时,把它替换成 UI 选区、Track Event 或输入事件算出来的起止时间。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
INCLUDE PERFETTO MODULE slices.with_context;
INCLUDE PERFETTO MODULE time.conversion;

WITH target_window(start_ts, end_ts) AS (
VALUES (123000000000, 123500000000)
),
target_process(upid) AS (VALUES (NULL)),
target_slices AS (
SELECT
s.ts,
s.dur,
s.upid,
s.utid,
s.name,
s.thread_name,
s.process_name,
MAX(0, MIN(s.ts + s.dur, w.end_ts) - MAX(s.ts, w.start_ts)) AS overlap_dur
FROM thread_slice s
JOIN target_window w
WHERE s.upid = (SELECT upid FROM target_process)
AND (s.is_main_thread = 1 OR s.thread_name = 'RenderThread')
AND s.dur > 0
AND s.ts < w.end_ts
AND s.ts + s.dur > w.start_ts
)
SELECT
upid,
utid,
time_to_ms(ts) AS ts_ms,
ROUND(overlap_dur / 1e6, 3) AS overlap_ms,
ROUND(dur / 1e6, 3) AS original_dur_ms,
name,
thread_name,
process_name
FROM target_slices
WHERE overlap_dur > time_from_ms(5)
ORDER BY overlap_ms DESC;

这条查询对应 UI 里的“找主线程长任务”。它不能直接给根因,也不能直接替代慢帧指标;它只是把目标窗口里的可疑点列出来:哪个线程、哪个切片、在窗口内占了多久、原始切片有多长。

Runnable 不是 Running

一个长切片可能是代码执行了很久,也可能是切片跨过了等待时间。要继续看调度状态。thread_state.state = 'Running' 对应实际占用 CPU 的区间;R、R+ 这类状态表示线程可运行但没有在 CPU 上跑,其中 R+ 通常代表被抢占后仍处于 runnable。

做调度分析前先检查同一窗口内有没有 thread_state/sched 数据。目标线程匹配不到,或者 stats 里有 ftrace loss/drop/error 时,报告要输出 insufficient_sched_evidence 或 sched_evidence_grade=weak:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
WITH target_window(start_ts, end_ts) AS (
VALUES (123000000000, 123500000000)
),
target_process(upid) AS (VALUES (NULL)),
target_threads AS (
SELECT th.utid
FROM thread th
JOIN process p USING (upid)
WHERE p.upid = (SELECT upid FROM target_process)
AND (th.is_main_thread = 1 OR th.name = 'RenderThread')
)
SELECT 'thread_state_rows' AS check_name, COUNT(*) AS row_count
FROM thread_state ts
JOIN target_threads t USING (utid)
JOIN target_window w
WHERE ts.dur > 0
AND ts.ts < w.end_ts
AND ts.ts + ts.dur > w.start_ts
UNION ALL
SELECT 'sched_rows' AS check_name, COUNT(*) AS row_count
FROM sched s
JOIN target_threads t USING (utid)
JOIN target_window w
WHERE s.dur > 0
AND s.ts < w.end_ts
AND s.ts + s.dur > w.start_ts;

这段查询仍然限制在同一个目标窗口内,把主线程与 RenderThread 的 Running、Runnable、S、D 拆开统计:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
WITH target_window(start_ts, end_ts) AS (
VALUES (123000000000, 123500000000)
),
target_process(upid) AS (VALUES (NULL)),
target_threads AS (
SELECT th.utid, p.name AS process_name, th.name AS thread_name
FROM thread th
JOIN process p USING (upid)
WHERE p.upid = (SELECT upid FROM target_process)
AND (th.is_main_thread = 1 OR th.name = 'RenderThread')
),
state_in_window AS (
SELECT
t.utid,
t.process_name,
t.thread_name,
CASE
WHEN ts.state = 'Running' THEN 'running'
WHEN ts.state GLOB 'R*' THEN 'runnable'
WHEN ts.state = 'S' THEN 'interruptible_sleep'
WHEN ts.state GLOB 'D*' THEN 'uninterruptible_blocked'
ELSE 'other_' || COALESCE(ts.state, 'unknown')
END AS state_bucket,
MAX(0, MIN(ts.ts + ts.dur, w.end_ts) - MAX(ts.ts, w.start_ts)) AS overlap_dur
FROM thread_state ts
JOIN target_threads t USING (utid)
JOIN target_window w
WHERE ts.dur > 0
AND ts.ts < w.end_ts
AND ts.ts + ts.dur > w.start_ts
)
SELECT
utid,
process_name,
thread_name,
state_bucket,
ROUND(SUM(overlap_dur) / 1e6, 3) AS overlap_ms
FROM state_in_window
GROUP BY utid, process_name, thread_name, state_bucket
ORDER BY thread_name, overlap_ms DESC;

S 常见于正常 sleep 或 futex 等待,D 及附加标志(如 D|K)属于不可中断等待类别;需要定责时再结合 thread_state 的 blocked reason、io_wait、waker 字段和 schema 版本确认。点击响应、滑动首帧、启动首帧这类场景里,出现长 Runnable 说明 CPU 竞争或调度延迟也要一起查,但它还不能单独定责:线程 running time 是线程维度,CPU busy 和 cluster 解释要另查 sched.cpu、CPU idle、CPU frequency、capacity,并限制在同一窗口内。

把查询放到命令行

同一段 SQL 可以放进 queries/slow_slices.sql,再用 Trace Processor 执行:

1
2
3
./trace_processor query \
-f queries/slow_slices.sql \
trace.perfetto-trace

到这一步,分析已经从截图变成了文本文件。文本文件可以评审、复用、放进 CI,也可以发给同事确认。

Python API 批量分析

一份 Trace 可以用 UI 慢慢看,多份 Trace 就该让脚本跑。脚本要完成四件事:读取 Trace,读取同名 .json 元数据文件,跑质量门禁,按同一个目标窗口输出稳定字段。重点看 TraceProcessor(trace=...)、tp.query(...) 和报告列名。

1
python3 -m pip install perfetto==0.58.2

下方程序要求环境变量 TRACE_PROCESSOR_BIN 指向已验证版本的原生可执行文件绝对路径;请先用该文件的 --version 检查并保存输出。它不会自动从 Python 包版本推断原生版本。每份 foo.perfetto-trace 的输入元数据放在同目录 foo.json,不是所有 Trace 共用一个 metadata.json。必须提供 process_name、本文件的 target_upid、window_start_ts、window_end_ts,后两项为原始时间域中的整数纳秒。

回归平台里不要依赖“首次运行临时下载”。CI 应该固定 Python perfetto 包版本,预热或缓存 native Trace Processor——TraceProcessorConfig(bin_path=...) 可以直接指定预先下发的二进制,避免 CI 机器首次运行时临时下载——并把 trace_processor --version、TraceConfig id、SQL package version 写入 metadata。否则一次工具升级就可能让 before/after 的解析口径漂移。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
255
256
257
258
259
260
261
262
263
264
265
266
267
268
269
270
271
272
273
274
275
276
277
278
279
280
281
282
283
284
285
286
287
288
289
290
291
292
293
294
295
296
297
298
299
300
301
302
303
304
305
306
307
308
309
310
311
312
313
314
315
316
317
318
319
320
321
322
323
324
325
326
327
328
329
330
331
332
333
334
335
336
337
338
339
import csv
import json
import os
from importlib.metadata import version
from pathlib import Path

from perfetto.trace_processor import TraceProcessor, TraceProcessorConfig

TP_BIN = Path(os.environ["TRACE_PROCESSOR_BIN"])
if not TP_BIN.is_absolute() or not TP_BIN.is_file():
raise ValueError("TRACE_PROCESSOR_BIN must be an existing absolute file path")
TP_CONFIG = TraceProcessorConfig(bin_path=str(TP_BIN))
PYTHON_PACKAGE_VERSION = version("perfetto")

QUALITY_DETAIL_QUERY = """
SELECT
name,
idx,
severity,
source,
value
FROM stats
WHERE value != 0
AND (
severity IN ('error', 'data_loss')
OR LOWER(name) LIKE '%loss%'
OR LOWER(name) LIKE '%drop%'
OR LOWER(name) LIKE '%parse%'
OR name IN ('ftrace_setup_errors', 'traced_buf_chunks_overwritten',
'traced_buf_chunks_discarded', 'traced_flushes_failed',
'traced_final_flush_failed')
)
ORDER BY severity, source, name, idx;
"""

FRAME_TIMELINE_QUERY = """
SELECT
(SELECT COUNT(*) FROM actual_frame_timeline_slice) AS actual_count,
(SELECT COUNT(*) FROM expected_frame_timeline_slice) AS expected_count;
"""

SLOW_SLICE_QUERY_TEMPLATE = """
INCLUDE PERFETTO MODULE slices.with_context;
INCLUDE PERFETTO MODULE time.conversion;

WITH target_window(start_ts, end_ts) AS (
VALUES ({start_ts}, {end_ts})
),
target_slices AS (
SELECT
s.process_name,
s.upid,
s.thread_name,
s.utid,
s.name AS slice_name,
MAX(0, MIN(s.ts + s.dur, w.end_ts) - MAX(s.ts, w.start_ts)) AS overlap_dur
FROM thread_slice s
JOIN target_window w
WHERE s.upid = {target_upid}
AND (s.is_main_thread = 1 OR s.thread_name = 'RenderThread')
AND s.dur > 0
AND s.ts < w.end_ts
AND s.ts + s.dur > w.start_ts
)
SELECT
process_name,
upid,
thread_name,
utid,
slice_name,
COUNT(*) AS slice_count,
ROUND(SUM(overlap_dur) / 1e6, 3) AS overlap_total_ms,
ROUND(MAX(overlap_dur) / 1e6, 3) AS max_overlap_ms
FROM target_slices
WHERE overlap_dur > time_from_ms(5)
GROUP BY process_name, upid, thread_name, utid, slice_name
ORDER BY overlap_total_ms DESC, upid, utid, slice_name
LIMIT 20;
"""

STATE_QUERY_TEMPLATE = """
WITH target_window(start_ts, end_ts) AS (
VALUES ({start_ts}, {end_ts})
),
target_threads AS (
SELECT th.utid, p.name AS process_name, th.name AS thread_name
FROM thread th
JOIN process p USING (upid)
WHERE p.upid = {target_upid}
AND (th.is_main_thread = 1 OR th.name = 'RenderThread')
),
state_in_window AS (
SELECT
t.process_name,
t.thread_name,
ts.utid,
CASE
WHEN ts.state = 'Running' THEN 'running_ns'
WHEN ts.state GLOB 'R*' THEN 'runnable_ns'
WHEN ts.state = 'S' THEN 'sleeping_ns'
WHEN ts.state GLOB 'D*' THEN 'uninterruptible_blocked_ns'
WHEN ts.state IS NULL THEN 'unknown_state_ns'
ELSE 'other_state_ns'
END AS state_bucket,
MAX(0, MIN(ts.ts + ts.dur, w.end_ts) - MAX(ts.ts, w.start_ts)) AS overlap_dur
FROM thread_state ts
JOIN target_threads t USING (utid)
JOIN target_window w
WHERE ts.dur > 0
AND ts.ts < w.end_ts
AND ts.ts + ts.dur > w.start_ts
)
SELECT
process_name,
thread_name,
utid,
state_bucket,
SUM(overlap_dur) AS overlap_ns
FROM state_in_window
GROUP BY process_name, thread_name, utid, state_bucket;
"""

def sql_string(value):
return "'" + value.replace("'", "''") + "'"

def load_metadata(trace_path):
metadata_path = trace_path.with_suffix(".json")
return json.loads(metadata_path.read_text(encoding="utf-8"))

def required_int(metadata, key):
value = metadata[key]
if type(value) is not int or not 0 <= value < 2**63:
raise ValueError(f"{key} must be a nonnegative signed-64-bit JSON integer")
return value

def quality_summary(rows, frame_row):
data_loss_sources = []
ftrace_issue_rows = 0
for row in rows:
name = row.name or ""
severity = row.severity or ""
if severity == "data_loss":
data_loss_sources.append(f"{row.source}:{name}[{row.idx}]")
if "ftrace" in name.lower() and (
severity in ("error", "data_loss")
or "loss" in name.lower()
or "drop" in name.lower()
):
ftrace_issue_rows += 1

frame_available = (frame_row.actual_count or 0) > 0 and (frame_row.expected_count or 0) > 0
if ftrace_issue_rows:
grade = "weak"
reason = "ftrace_stats_findings"
elif data_loss_sources:
grade = "needs_metric_scope_check"
reason = "data_loss"
elif rows:
grade = "needs_metric_scope_check"
reason = "stats_findings" # Parser errors, setup notices, and overwrite counters
elif not frame_available:
grade = "frame_metrics_unavailable"
reason = "missing_frame_timeline"
else:
grade = "no_selected_stats_findings"
reason = ""

return {
"quality_grade": grade,
"degrade_reason": reason,
"data_loss_sources": ";".join(data_loss_sources),
"ftrace_issue_rows": ftrace_issue_rows,
"frame_timeline_available": frame_available,
}

files = sorted(Path("traces").glob("*.perfetto-trace"))
if not files:
raise ValueError("No input traces")

quality_dir = Path("quality")
quality_dir.mkdir(exist_ok=True)

with open("report.partial.csv", "w", newline="", encoding="utf-8") as fp:
writer = csv.DictWriter(
fp,
fieldnames=[
"trace_name",
"group",
"scenario",
"window_source",
"window_name",
"window_start_ts",
"window_end_ts",
"window_start_ms",
"window_dur_ms",
"python_package_version",
"metric_status",
"target_thread_count",
"observed_slice_count",
"quality_grade",
"degrade_reason",
"data_loss_sources",
"ftrace_issue_rows",
"frame_timeline_available",
"sched_coverage",
"process_name",
"upid",
"thread_name",
"utid",
"slice_name",
"slice_count",
"overlap_total_ms",
"max_overlap_ms",
"running_ms",
"runnable_ms",
"sleeping_ms",
"uninterruptible_blocked_ms",
"other_state_ms",
"unknown_state_ms",
],
)
writer.writeheader()

for trace_path in files:
metadata = load_metadata(trace_path)
process_name = metadata["process_name"]
if not isinstance(process_name, str) or not process_name:
raise ValueError("process_name must be a nonempty string")
target_upid = required_int(metadata, "target_upid")
start_ts = required_int(metadata, "window_start_ts")
end_ts = required_int(metadata, "window_end_ts")
if end_ts <= start_ts:
raise ValueError(f"Invalid target window: {trace_path}")

slow_slice_query = SLOW_SLICE_QUERY_TEMPLATE.format(
start_ts=start_ts,
end_ts=end_ts,
target_upid=target_upid,
)
state_query = STATE_QUERY_TEMPLATE.format(
start_ts=start_ts,
end_ts=end_ts,
target_upid=target_upid,
)

with TraceProcessor(trace=str(trace_path), config=TP_CONFIG) as tp:
bounds = next(iter(tp.query("SELECT start_ts, end_ts FROM trace_bounds")))
if start_ts < bounds.start_ts or end_ts > bounds.end_ts:
raise ValueError(f"Window outside trace bounds: {trace_path}")
identity = list(tp.query(
f"SELECT upid FROM process WHERE upid = {target_upid} "
f"AND name = {sql_string(process_name)}"
))
if len(identity) != 1:
raise ValueError(f"Process identity mismatch: {trace_path}")
scope_row = next(iter(tp.query(f"""
INCLUDE PERFETTO MODULE slices.with_context;
WITH target_threads AS (
SELECT utid FROM thread
WHERE upid = {target_upid}
AND (is_main_thread = 1 OR name = 'RenderThread')
)
SELECT
(SELECT COUNT(*) FROM target_threads) AS thread_count,
(SELECT COUNT(*) FROM thread_slice
WHERE utid IN (SELECT utid FROM target_threads)
AND dur > 0 AND ts < {end_ts}
AND ts + dur > {start_ts}) AS observed_slice_count;
""")))
quality_rows = list(tp.query(QUALITY_DETAIL_QUERY))
frame_row = next(iter(tp.query(FRAME_TIMELINE_QUERY)))
slow_rows = list(tp.query(slow_slice_query))
state_rows = list(tp.query(state_query))

(quality_dir / f"{trace_path.stem}.stats.json").write_text(json.dumps(
[{key: getattr(row, key) for key in ("name", "idx", "severity", "source", "value")}
for row in quality_rows], ensure_ascii=False, indent=2), encoding="utf-8")
quality = quality_summary(quality_rows, frame_row)
state_by_thread = {}
for row in state_rows:
state_by_thread.setdefault((row.utid, row.thread_name), {})[row.state_bucket] = row.overlap_ns

if slow_rows:
metric_status = "observed_top20_slow_slice_groups"
elif scope_row.thread_count == 0:
metric_status = "missing_target_threads"
elif scope_row.observed_slice_count == 0:
metric_status = "no_observed_closed_slices"
else:
metric_status = "no_slow_slices_in_observed_data"
no_slow_observed = metric_status == "no_slow_slices_in_observed_data"
if not slow_rows:
slow_rows = [None]

for row in slow_rows:
states = state_by_thread.get((row.utid, row.thread_name), {}) if row else {}
# thread_state intervals for one utid are disjoint; sum exact ns.
covered_ns = sum(states.values())
full_coverage = bool(states) and covered_ns == end_ts - start_ts
sched_coverage = "full" if full_coverage else ("partial" if states else "missing")
fill_zero = full_coverage and not quality_rows and not states.get("unknown_state_ns", 0)
def state_value(key):
value = states.get(key, 0 if fill_zero else None)
return round(value / 1e6, 3) if value is not None else ""

writer.writerow({
"trace_name": trace_path.name,
"group": metadata.get("group", "unknown"),
"scenario": metadata.get("scenario", "unknown"),
"window_source": metadata.get("window_source", "metadata"),
"window_name": metadata.get("window_name", ""),
"window_start_ts": start_ts,
"window_end_ts": end_ts,
"window_start_ms": round(start_ts / 1_000_000, 3),
"window_dur_ms": round((end_ts - start_ts) / 1_000_000, 3),
"python_package_version": PYTHON_PACKAGE_VERSION,
"metric_status": metric_status,
"target_thread_count": scope_row.thread_count,
"observed_slice_count": scope_row.observed_slice_count,
**quality,
"sched_coverage": sched_coverage,
"process_name": row.process_name if row else process_name,
"upid": row.upid if row else target_upid,
"thread_name": row.thread_name if row else "",
"utid": row.utid if row else "",
"slice_name": row.slice_name if row else "",
"slice_count": row.slice_count if row else (0 if no_slow_observed else ""),
"overlap_total_ms": round(row.overlap_total_ms, 3) if row else (0 if no_slow_observed else ""),
"max_overlap_ms": round(row.max_overlap_ms, 3) if row else (0 if no_slow_observed else ""),
"running_ms": state_value("running_ns"),
"runnable_ms": state_value("runnable_ns"),
"sleeping_ms": state_value("sleeping_ns"),
"uninterruptible_blocked_ms": state_value("uninterruptible_blocked_ns"),
"other_state_ms": state_value("other_state_ns"),
"unknown_state_ms": state_value("unknown_state_ns"),
})

Path("report.partial.csv").replace("report.csv")
print("Completed: report.csv")

foo.json 缺字段、时间戳不是 JSON 整数、进程身份不符或窗口超出 Trace 边界时,脚本停止。frame_timeline_available 只说明全 Trace 两类帧表均有记录,不是窗口/进程覆盖认证;no_selected_stats_findings 也只说明所查 stats 未报警。sched_coverage 按同一 utid 的互不重叠状态区间精确纳秒求和,只有整窗覆盖、未见所选质量告警且无未知状态时才把缺失状态填 0。部分覆盖仍保留已观测量,不能当完整窗口总量。无慢切片的汇总行不带线程身份,调度列留空;重复 utid 的调度列要在同一 Trace 内去重,不能跨 Trace 按 utid 合并。

只有本次程序正常退出并显示完成信息后,report.csv 才代表本批结果;中途失败留下 report.partial.csv,原有 report.csv 可能属于上次运行。ftrace_issue_rows 数的是命中的 stats 行数,不是丢失事件数。

这个脚本仍然是起点,但它已经有长期脚本需要的三个特征:同一份窗口化 SQL、同一组阈值、同一类输出。quality/*.stats.json 保留查询到的 stats 明细,CSV 用 quality_grade/degrade_reason/data_loss_sources 表示降级原因;SLOW_SLICE_QUERY_TEMPLATE 只看目标窗口内主线程和 RenderThread,不会把整份 Trace 的后台线程长任务误写成 UI 卡顿证据。

Trace 数量增多后,可以用官方 BatchTraceProcessor 并行执行相同查询。下面让每份 Trace 自己寻找唯一的 feed_scroll 主线程 marker,避免复用另一份文件的绝对时间戳;缺失或多个 marker 时明确拒绝选择,需按前面的 metadata 方式逐文件确定窗口。query_and_flatten() 的来源列由 resolver 决定,本文固定包的文件系统 resolver 提供 _path,不能假设任意自定义 resolver 都带来源列。

1
python3 -m pip install perfetto==0.58.2 pandas
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
import glob
import os
from pathlib import Path
import pandas as pd
from perfetto.batch_trace_processor.api import BatchTraceProcessor, BatchTraceProcessorConfig
from perfetto.trace_processor import TraceProcessorConfig

QUERY = """
INCLUDE PERFETTO MODULE slices.with_context;
INCLUDE PERFETTO MODULE time.conversion;

WITH candidate_windows AS (
SELECT upid, ts AS start_ts, ts + dur AS end_ts
FROM thread_slice
WHERE process_name = 'com.example.app'
AND is_main_thread = 1 AND name = 'feed_scroll' AND dur > 0
),
target_window AS (
SELECT * FROM candidate_windows
WHERE (SELECT COUNT(*) FROM candidate_windows) = 1
),
target_slices AS (
SELECT
s.process_name,
s.upid,
thread_name,
utid,
name AS slice_name,
MAX(0, MIN(ts + dur, w.end_ts) - MAX(ts, w.start_ts)) AS overlap_dur
FROM thread_slice s
JOIN target_window w ON s.upid = w.upid
WHERE dur > 0
AND (is_main_thread = 1 OR thread_name = 'RenderThread')
AND ts < w.end_ts
AND ts + dur > w.start_ts
),
grouped AS (
SELECT
process_name,
upid,
thread_name,
utid,
slice_name,
COUNT(*) AS slice_count,
ROUND(SUM(overlap_dur) / 1e6, 3) AS overlap_total_ms
FROM target_slices
WHERE overlap_dur > time_from_ms(5)
GROUP BY process_name, upid, thread_name, utid, slice_name
ORDER BY overlap_total_ms DESC, upid, utid, slice_name
LIMIT 20
)
SELECT 'observed_top20_slow_slice_groups' AS metric_status, * FROM grouped
UNION ALL
SELECT
CASE (SELECT COUNT(*) FROM candidate_windows)
WHEN 0 THEN 'missing_marker'
WHEN 1 THEN 'no_slow_slices_in_observed_data'
ELSE 'ambiguous_marker'
END,
NULL, NULL, NULL, NULL, NULL, NULL, NULL
WHERE NOT EXISTS (SELECT 1 FROM grouped);
"""

files = sorted(glob.glob("traces/*.perfetto-trace"))
if not files:
raise ValueError("No input traces")
tp_bin = Path(os.environ["TRACE_PROCESSOR_BIN"])
if not tp_bin.is_absolute() or not tp_bin.is_file():
raise ValueError("TRACE_PROCESSOR_BIN must be an existing absolute file path")
config = BatchTraceProcessorConfig(
tp_config=TraceProcessorConfig(bin_path=str(tp_bin))
)
outputs = []
for offset in range(0, len(files), 4):
with BatchTraceProcessor(files[offset:offset + 4], config=config) as btp:
outputs.append(btp.query_and_flatten(QUERY))
result = pd.concat(outputs, ignore_index=True)
print(result) # The filesystem resolver adds _path to identify each trace.

示例每批最多加载 4 份 Trace,处理完即关闭;这个数量只是可调起点,不是内存上限保证。BTP 会让当前批次的解析数据驻留内存,限制加载并发不能替代缩小批次。默认加载/查询失败直接抛错;若改成 INCREMENT_STAT,失败文件会被丢弃,必须另报失败数并防止样本量悄悄变少。

从临时查询到稳定指标

上面的批处理示例展示 API 用法,不代替前一程序的逐文件 metadata 与质量检查。metric_status 保留无结果的文件;只有某些已观测切片中没有超过阈值,才能写 no_slow_slices_in_observed_data,这仍不是“业务没有卡顿”。Top 20 是展示上限,不是全部切片组。

临时 SQL 用来探索,稳定指标用来长期比较。把查询放进工程前,至少补齐四组约束:

  • 输出契约:列名、单位、排序规则要固定。dur > time_from_ms(5) 比裸写 5e6 更适合长期脚本;列名写成 overlap_total_ms,读报告的人才知道它已经和目标窗口做过交集。
  • 身份归属:多进程场景使用 utid/upid,线程名只适合读,不适合当唯一标识。main、RenderThread、Binder:* 都可能重复。
  • 目标窗口:点击、启动、滑动首帧、Camera open 这类问题不能只看整份 Trace 的总量。报告里要带 window_source/window_name/window_start_ms/window_dur_ms。
  • 数据质量:每份 Trace 都要带 stats 明细和降级字段。quality_grade/degrade_reason/missing_sources/fallback_used 比一个总数更适合做回归门禁。

复杂 JOIN 优先找标准库视图。thread_slice、process_slice、thread_or_process_slice 能减少低级错误。长期项目优先考虑 Trace Summary;官方已经把 v2 summary 作为更适合结构化输出的方向,旧的 v1 metrics 不适合作为新方案起点。

一个实用标准是:查询结果能不能直接放进版本对比。如果还需要人手工解释“这一列上次叫 A,这次叫 B”,它就还不是稳定指标。

还有一条容易被忽略:指标要写出失败时的解释口径。比如“5ms 以上主线程 slice 累计持续时间”只能回答切片里有多少长任务,它不能独立证明卡顿;“Runnable 总耗时”只能说明线程有等待 CPU 的迹象,它也不能替代 CPU 频率、负载和调度器证据。FrameTimeline 缺失时,报告应写 metric_status=unavailable、fallback_used=false、degrade_reason=missing_frame_timeline;ftrace loss 命中时,调度类指标应写 sched_evidence_grade=weak。

嵌套 slice 的持续时间会重叠;SUM(overlap_dur) 是切片累计量,不能当成互不重叠的墙钟时间或 CPU 时间,也不能跨父子切片直接相加来计算线程占用率。

同一目标窗口里的 CPU frequency、CPU idle、thermal、cluster/CPU placement 更适合放在报告的“解释变量”里。它们通常不单独定责,但能解释为什么同样的业务切片在某次 Trace 里变慢。

多 Trace 才能回答回归问题

单份 Trace 适合定位一个现场,多份 Trace 才能回答“优化有没有稳定变好”。很多性能报告的问题不在 Trace 本身,而在证据组织:截图很多,结论下得重,但没有固定配置、没有样本数、没有 data loss 检查、没有 before/after 统计口径。

多 Trace 分析要先固定输入契约。最小集合是 trace_name/scenario/group/device/build/config_id;duration_ms/thermal_state/trace_processor_version/sql_package_version 用来排除环境和工具漂移。每一批 Trace 至少要带这些字段:

字段 例子 用途
trace_name after-run03.perfetto-trace 追溯原始文件
scenario feed_scroll_120hz 区分场景
group before / after 做版本对比
device Pixel_8 按机型聚合
build UP1A.xxx 定位系统版本
config_id ui_jank_v4 确认 TraceConfig 一致
duration_ms 30000 判断采集窗口
thermal_state nominal 排除温控干扰
trace_processor_version 实际 --version 输出 排除解析器或 stdlib 变化
sql_package_version perf-v3 确认查询逻辑一致

这些字段可以来自文件名、metadata、测试平台,也可以放进 case 包里的 metadata.json。缺少这些字段时,数字很难解释。

下面是假设数据的示意 CSV,额外加入了人工复核后填写的 conclusion_level/next_action 两列;quality_grade 使用上文脚本实际会输出的取值。

1
2
3
4
5
trace_name,group,scenario,window_name,quality_grade,degrade_reason,ftrace_issue_rows,frame_timeline_available,thread_name,slice_name,slice_count,overlap_total_ms,runnable_ms,conclusion_level,next_action
before-run01.perfetto-trace,before,feed_scroll_120hz,feed_scroll,no_selected_stats_findings,,0,true,main,inflate,4,38.41,2.10,info,compare_after
before-run02.perfetto-trace,before,feed_scroll_120hz,feed_scroll,no_selected_stats_findings,,0,true,RenderThread,DrawFrame,3,51.02,4.33,info,compare_after
after-run01.perfetto-trace,after,feed_scroll_120hz,feed_scroll,weak,ftrace_stats_findings,1,true,main,inflate,5,71.82,18.40,needs_retrace,recollect_trace
after-run02.perfetto-trace,after,feed_scroll_120hz,feed_scroll,no_selected_stats_findings,,0,true,RenderThread,DrawFrame,2,25.77,1.92,needs_more_runs,collect_more_runs

质量问题不要只输出一个总数。ftrace loss 会直接影响 sched/thread_state/wakeup 结论,但不一定让 App Track Event 完全不可用;FrameTimeline 缺失会影响帧指标,但不一定影响 Binder 或内存分析。报告里至少要保留 name/source/idx 或按数据源聚合,回归门禁再按指标依赖决定复抓、剔除或降级。

回归判定也不要只比较平均值。建议同时保留中位数、p95、最差值和每次运行的原始值:

指标 方向 判定建议
FrameTimeline overrun / jank rate 越低越好 看 p95_frame_overrun_ms、worst_frame_overrun_ms、jank_count、jank_rate、jank_type 分布;valid_frame_count 用来表示样本量
launch duration 越低越好 单独定义起止点,不要和帧时长混在一起
jank count / jank rate 越低越好 同时保留总帧数、有效帧数、窗口时长和比例
slow binder count 越低越好 看总数,也看是否集中在同一阶段
CPU Running time 不一定 要和场景动作、帧窗口一起看
RSS/PSS/未释放 native allocation 通常越低越好 看峰值、增长斜率和是否回落
battery current / power rail 不一定 同设备同条件 A/B 才有意义

不能仅凭“各跑 5 次”保证检出 1% 或 2% 的变化;可分辨的效应取决于波动、实验设计和区间估计。报告里要写清样本数和环境条件;样本数不足、温控状态不同、质量门禁不干净时,结论要降级。

Trace Summary 放长期指标

直接 SELECT 很灵活,但输出 schema 会跟着查询变化。接平台、看板、CI 时,工具更需要稳定结构。Trace Summary 的设计目标就是把指标写进统一的 TraceSummary protobuf。

当前命令行入口是 summarize 子命令。如果前面下载的是 trace_processor wrapper,就沿用同一个入口。

下面这个最小 spec.textproto 用内存指标展示 Trace Summary 的结构。这里选内存只是为了让例子短一点;等长切片、帧、Binder 这类指标的 SQL 稳定后,也可以按同样方式迁进去。

这个例子按 upid + process_name 分组,避免把同名进程的不同生命期混合平均。它计算模块中已观测区间的 RSS+swap 时长加权均值,不是 PSS、峰值或应用全进程同时占用的总和,也尚未裁剪到业务窗口;缺失采样和覆盖仍需单独记录。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
metric_spec {
id: "memory_per_process"
dimensions: "upid"
dimensions: "process_name"
value: "avg_rss_and_swap"
unit: BYTES
polarity: LOWER_IS_BETTER
query {
table {
table_name: "memory_rss_and_swap_per_process"
}
referenced_modules: "linux.memory.process"
group_by {
column_names: "upid"
column_names: "process_name"
aggregates {
column_name: "rss_and_swap"
op: DURATION_WEIGHTED_MEAN
result_column_name: "avg_rss_and_swap"
}
}
}
}

然后运行这个 summary spec,并请求 memory_per_process 这个 metric:

1
2
3
./trace_processor summarize \
--metrics-v2 memory_per_process \
trace.perfetto-trace spec.textproto

该版本默认打印 textproto;需要二进制 protobuf 时加 --format binary 并重定向到文件。统一 protobuf 结构并不自动固定指标语义;跨 Trace 对比还要固定 spec、模块版本、窗口和缺失数据规则,upid 仅在单份 Trace 内有意义。

源码树里的 trace_processor_shell summarize 也能表达同一件事。旧版 --summary --summary-spec ... --summary-metrics-v2 ... 形式仍受支持,但新脚本优先使用子命令写法,读者对照官方文档时不容易走岔。

Trace Summary 适合长期指标:内存、启动、帧、Binder、CPU、功耗这类需要跨版本长期跟踪的数据。临时排障仍然可以直接写 SQL。帧指标迁进去时,App FrameTimeline、SurfaceFlinger/display 侧指标要分开输出,不要把 RenderThread 长 slice 当成 frame duration。

一个 summary spec 至少要说明 metric id、维度和值。单个 metric_spec 可以直接声明 unit 和 polarity,例如内存值用 BYTES,方向是 LOWER_IS_BETTER;模板场景再用 value_column_specs 给多个 value column 分别声明单位和方向。这些是展示提示,不是自动回归判定;门槛、可比性和显著性仍由消费方定义。

另一个适合平台化的能力是 metadata_query_id。如果 spec 同时定义一个返回 key / value 的 metadata query,命令行可以加 --metadata-query,Python API 也可以传 metadata_query_id。这适合把 device、build、scenario、config_id 这类字段随 summary 一起输出,后续聚合时不用再猜文件名。

项目里可以先用 Python + CSV 起步;当字段稳定、消费方固定、指标需要长期维护时,再把关键指标迁到 Trace Summary。

容易踩的坑

  • 时间列如 ts/dur 默认按纳秒理解。报告字段写成 dur_ms/overlap_ms,阈值用 time_from_ms() 防住单位误读;耗时列用 ROUND(x / 1e6, 3),不要用会截断成整毫秒的 time_to_ms();counter/value 类字段另看 track 和模块定义。
  • dur 为 -1 的 slice 是 Trace 结束时仍未闭合的事件。做窗口交集和 SUM(dur) 前先处理它,本文示例统一用 dur > 0 过滤;如果目标事件正好没闭合,要单独解释,不能当普通长切片统计。
  • main 和 RenderThread 不唯一。先过滤 process_name/upid,再过滤 thread_name/utid;报告里输出 upid/utid,免得踩线程名重复的坑。
  • pid/tid 会复用。脚本里优先使用 upid/utid;需要回到系统日志时,再把 tid/pid 作为辅助字段。
  • UI 里的可视轨道不一定对应单张原始表。报告里写清数据来源,例如 thread_slice、thread_state、actual_frame_timeline_slice,防止把展示层理解成 schema。
  • R、R+ 是 Runnable,Running 才是实际运行。报告里拆成 running_ms/runnable_ms/sleeping_ms/uninterruptible_blocked_ms,不要合成“线程忙”。
  • stats 有数据丢失时,不要写过强结论。保留 name/source/idx 和 degrade_reason,按指标依赖判断影响范围。
  • Schema 会演进。批处理脚本里遇到错误时,先用 PRAGMA table_info(table_name); 确认列是否存在;报告里保留 trace_processor_version/sql_package_version。
  • before/after 的 TraceConfig 变化若影响指标依赖的数据源、过滤、采样或时间范围,就不能直接按同一口径比较。保留 config_id 和实际配置,确认差异无影响或复抓后再比较。
  • 只保留 report、不保留原始 Trace、config、SQL 和 metadata,后续无法复跑。最低限度也要保留 trace 文件名、配置 id、SQL 版本和窗口来源。

总结

截图能标出问题窗口;回归比较还需要保存窗口来源、采集质量、SQL 版本和原始 Trace。缺了这些输入,同一张图里的耗时也可能被不同人算出不同结果。

下一次拿到 Trace,可以按这个顺序做:先查 stats,再固定目标窗口和 upid/utid,然后把长 slice、Running/Runnable、帧指标和降级原因写成 CSV 或 Trace Summary。SQL 让判断可复查,但不能替代采集质量和场景定义;窗口错了、Trace 丢了、配置变了,查询写得再漂亮也只能得到不可信的数字。

我的开源项目 SmartPerfetto 也把这条路径接进了分析流程:先检查 Trace 质量,再按场景运行 PerfettoSQL,最后把结论连回原始证据。项目能力会随版本变化,具体范围见六周更新复盘和当前仓库说明。

参考文档

  1. Trace Processor
  2. Trace Processor Python API
  3. Getting Started with PerfettoSQL
  4. PerfettoSQL standard library
  5. PerfettoSQL Prelude tables
  6. Trace Processor Stats
  7. Trace Summarization
  8. Batch Trace Processor

原文时间换算核对版本:b23c67be1159e3f0b0657bd97be9e139e0d8ee2c(2026-09-19);2026-10 另核对 v58.3 SQL/CLI/Python 源码 与 Python 0.58.2 发布包。

关于我 && 博客

欢迎关注 Android Performance。

CATALOG
  1. 1. Perfetto 系列文章
  2. 2. 从截图结论到可复查查询
  3. 3. Trace Processor 是什么
  4. 4. 把 Trace 当成几张表
  5. 5. 一次完整分析怎么写成 SQL
    1. 5.1. 采集质量先决定结论语气
    2. 5.2. 先把目标窗口固定下来
    3. 5.3. 不要只靠 main 找线程
    4. 5.4. 长切片只能列可疑点
    5. 5.5. Runnable 不是 Running
    6. 5.6. 把查询放到命令行
  6. 6. Python API 批量分析
  7. 7. 从临时查询到稳定指标
  8. 8. 多 Trace 才能回答回归问题
  9. 9. Trace Summary 放长期指标
  10. 10. 容易踩的坑
  11. 11. 总结
  12. 12. 参考文档
  13. 13. 关于我 && 博客