技术复核 · 2026-10-13。 本文 2019 年的截图和日志保留为历史案例,不代表当前设备的性能。源码以 AOSP
android-9.0.0_r1、android-16.0.0_r1为核对基线。缓存原理仍有参考价值;原文关于逐帧重新分配、固定性能排序、用 gfxinfo 推断 CPU 负载的说法已修正。案例六与案例一整段日志重复,测量来源尚不能确认。
硬件加速与软件加速
很多人会把 Android 中的硬件加速和 Hardware Layer 搞混,以为启用了硬件加速,就是启用了 Hardware Layer。所以在说 Hardware Layer 之前,我们先说一下硬件加速。
原文推荐的两篇文章保留为历史阅读:Android 硬件加速原理与实现简介、理解 Android 硬件加速的小白文。API 支持范围以 Android 官方文档 为准。
对 View 绘制来说,软件路径主要由 CPU 栅格化,硬件加速路径由 HWUI 使用 GPU 完成相应绘制;CPU 仍要处理布局、记录绘制命令和提交工作。Skia 也支持 GPU 后端,不能把“用了 Skia”直接等同于软件渲染。
View 硬件加速从 Android 3.0(API 11)引入,对 targetSdkVersion ≥ 14 的应用默认开启;应用、Activity、Window 的配置以及 View 的软件 layer 会影响实际路径。原理和代码可以顺着上面的文章继续看,这里我想换个角度,用当时的 Systrace 带大家看看两种绘制路径的差别。
硬件加速 App 的表现
以滑动桌面为例。在 Android 5.0(API 21)以后的典型 HWUI 路径中,主线程和 RenderThread 配合准备一帧。
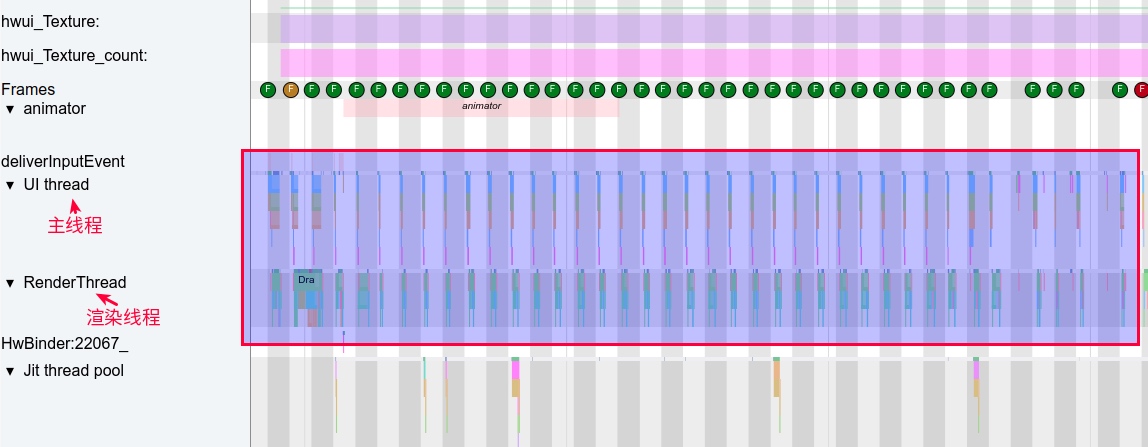
放大来看,主线程处理输入、动画以及按需执行的 traversal,RenderThread 处理后续绘制工作。图中旧注释把部分 measure/layout 工作归入“Draw”,应按具体 slice 和调用链区分。
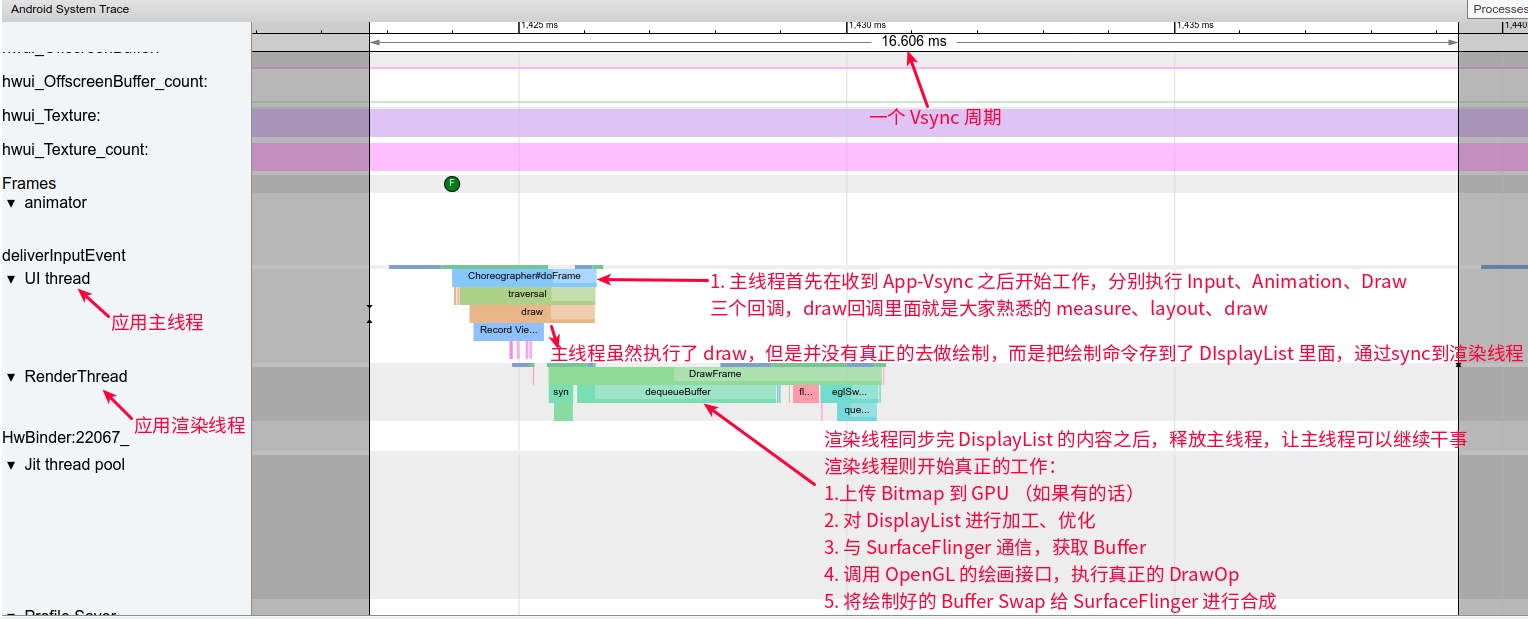
这些是 CPU 线程上的时间片。不能把 RenderThread 的执行时长当成 GPU 执行时长,也不能把提交完成或 eglSwapBuffers 返回当成实际屏幕呈现;主线程何时解除等待也取决于渲染路径。
软件加速 App 的表现
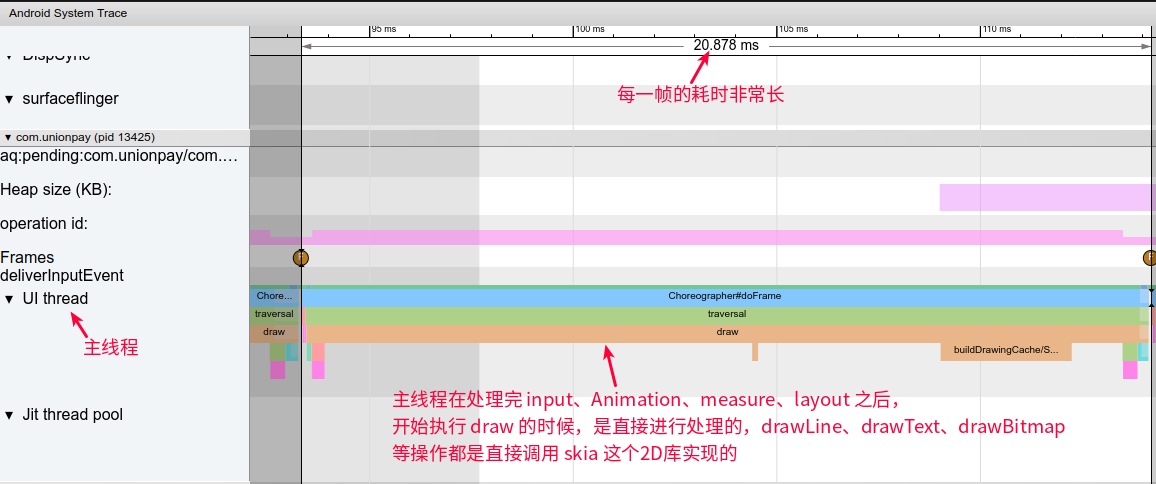
软件绘制这边,我当时找了云闪付作对照。那次滑动起来一卡一卡的,非常难受。截图里没有显示 RenderThread 工作,主线程中能看到绘制和 buildDrawingCache;这不能证明整个进程始终不存在 RenderThread,也不能推广为该 App 所有版本的配置。下载历史 Trace
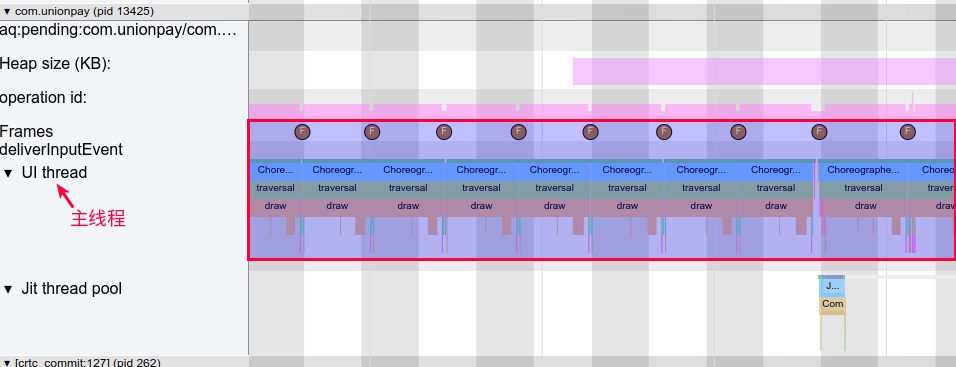
放大后的选中片段约为 20.878 ms,显示这段绘制较长;仅凭截图不能断言每一帧都超时。即使 App 在 CPU 上绘制窗口内容,后续系统合成仍可能使用 GPU 或硬件合成器。
总结
- 硬件加速改变 View 的绘制路径,不会让 CPU 工作消失;是否看到 RenderThread 不能单独作为整个 App 的开关判据。
- 软件 View、软件窗口和硬件加速窗口可以共存,App 绘制与系统合成也要分开看。
- 硬件加速通常适合现代 View 界面,但收益取决于工作量、资源和设备,不能仅凭两张图断言始终更快。
- 不支持的绘制操作要按 Android API 版本检查;必要时对局部 View 使用软件 layer,而不是无条件关闭整个应用的硬件加速。
Software Layer VS Hardware Layer
说完硬件渲染,再看 View 的 Software Layer 和 Hardware Layer。这里的 layer 是 View 的离屏像素缓存,不是 SurfaceFlinger 的合成 layer,也不等于整个窗口的硬件加速开关。
一个 View 的 layerType 有三种状态:
LAYER_TYPE_NONE:不额外建立显式的 View 像素 layer。LAYER_TYPE_SOFTWARE:将 View 内容用软件路径绘制到 Bitmap;所在窗口开启硬件加速时仍可使用。LAYER_TYPE_HARDWARE:在硬件加速的 View 层级中使用 GPU 离屏 layer;未开启硬件加速时按软件 layer 处理。
LAYER_TYPE_NONE
这是默认值。它不等于关闭硬件加速,也不等于每次都从零绘制:硬件路径仍可复用 RenderNode/display list 中记录的绘制命令。
LAYER_TYPE_SOFTWARE
Software Layer 是怎么用软件实现这个 layer 的呢?简单说,就是把 View 的内容缓存到 Bitmap。下面是 Android 9 View.java 的分配片段,变量由 framework 上下文提供,不是独立示例:
1 | bitmap = Bitmap.createBitmap(mResources.getDisplayMetrics(), |
内容失效时需要重绘 Bitmap;原 Bitmap 存在且尺寸不变时可复用,不能把每次重绘写成每次销毁和重新分配。
Software layer 的作用如下
- 软件绘制时,可将 View 及其子 View 作为一组应用透明度、颜色过滤或混合效果。
- 硬件绘制时,可承接该版本硬件路径不支持的局部操作;稳定内容也可能通过缓存减少重复绘制。
- 内容频繁更新时,要承担软件重绘及硬件路径中的纹理上传成本,不宜把它当作通用动画优化。
LAYER_TYPE_HARDWARE
Hardware Layer 将 View 内容绘制到 GPU 离屏资源,再用于窗口绘制。OpenGL 后端中可以用 FBO 理解它,但不能把所有 Android 版本和 Skia GL/Vulkan 后端都写成同一个 FBO 实现。它仍依赖当前 View 层级的硬件加速状态;关闭时退化为软件 layer。
Hardware layer 的作用:
Hardware Layer 可以给一组内容应用混合效果,也可能减少稳定复杂 View 在 translation、alpha、scale、rotation 动画中的重复绘制。缓存还会影响旋转或 3D 变换时的裁剪与采样,但不保证所有缩放都更清晰或更快。
动画期间临时使用 layer,结束后恢复原来的类型。下面的示例假定这段代码独占该 View 的 layerType,且在 UI 线程执行:
1 | ObjectAnimator anim = ObjectAnimator.ofFloat(view, "rotationY", 180f); |
ObjectAnimator 取消时也会走结束回调。不要让多个动画同时管理同一个 View 的 layerType。Android API 16 起也可以使用 withLayer(),由 ViewPropertyAnimator 在结束或取消后恢复调用时的类型:
1 | view.animate().rotationY(180f).withLayer().start(); |
只改变变换属性时,内容缓存可能复用;修改文本、增删子 View 或其他内容失效会要求重绘。是否重新分配离屏资源还要看尺寸、资源状态和具体后端,不能一概称为“FBO 被销毁”。
总结
- Software Layer 与 Hardware Layer 是不同的像素缓存路径;按绘制支持范围和实际开销选择。
- 对稳定复杂内容的属性动画,Hardware Layer 可能有收益,仍需与默认
NONE比较。 - 动画结束后恢复原类型,避免长期持有不需要的 layer。图形资源可能延后释放或被底层复用,不保证调用后进程内存立即下降。
不正确使用 LayerType 导致的性能问题案例
不正确使用 Software layer 引起的性能问题
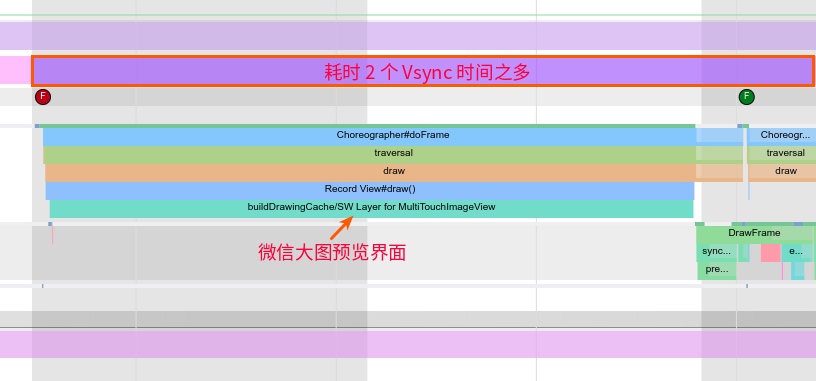
下面是微信朋友圈大图滑动的历史案例。主线程反复执行 buildDrawingCache/SW,说明软件缓存绘制在重复发生,可以继续追查内容更新与 invalidate 来源。它本身不能证明每次都分配新 Bitmap。下载历史 Trace
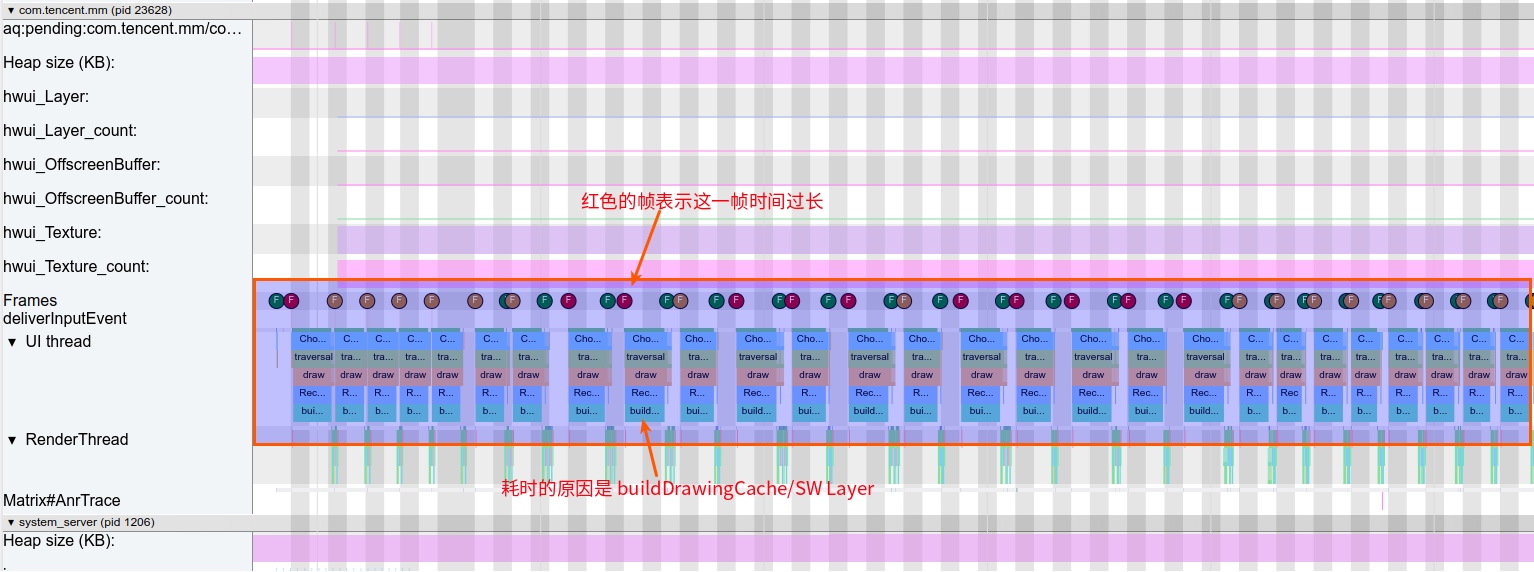
我当时滑这张朋友圈大图,顿挫感很明显。放大 Trace 后能看到绘制片段较长,值得检查是否可以避免重复软件绘制;还需要结合调度状态和其他工作确认卡顿原因。
代码流程
这里要区分 buildLayer() 的两条分支。以下摘自 Android 9 View.java:只有 LAYER_TYPE_SOFTWARE 走 buildDrawingCache → buildDrawingCacheImpl,硬件分支交给 ThreadedRenderer。它们是 framework 片段,依赖类内字段。
1 | public void buildLayer() { |
1 | public void buildDrawingCache(boolean autoScale) { |
Trace 包围的是缓存绘制调用,不是专门的分配事件。buildDrawingCacheImpl 会在 Bitmap 不存在或尺寸不匹配时分配;尺寸匹配时可以清理后重绘到已有 Bitmap。旧 drawing-cache API 在 API 28 已弃用,不建议应用直接调用这些方法作为现代优化入口。
不正确使用 Hardware layer 引起的性能问题
下面是桌面打开文件夹的历史案例,多个图标建立了 Hardware Layer,RenderThread 中能看到重复的 layer 绘制工作。缓存内容频繁变化时,额外离屏绘制可能抵消缓存收益;仅凭这些 slice 不能断言每一帧都销毁、重新分配 buffer。下载历史 Trace
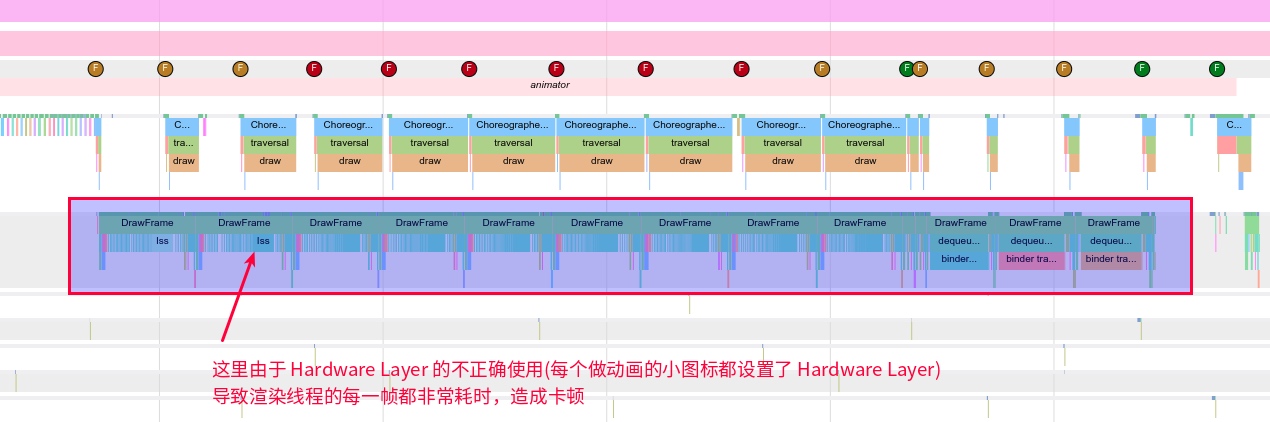
放大图中选中区间约 21.68 ms,其中一个 ShortcutIcon 的 layer 绘制约 4.783 ms。应区分单个 slice、整帧与 GPU 执行时间。
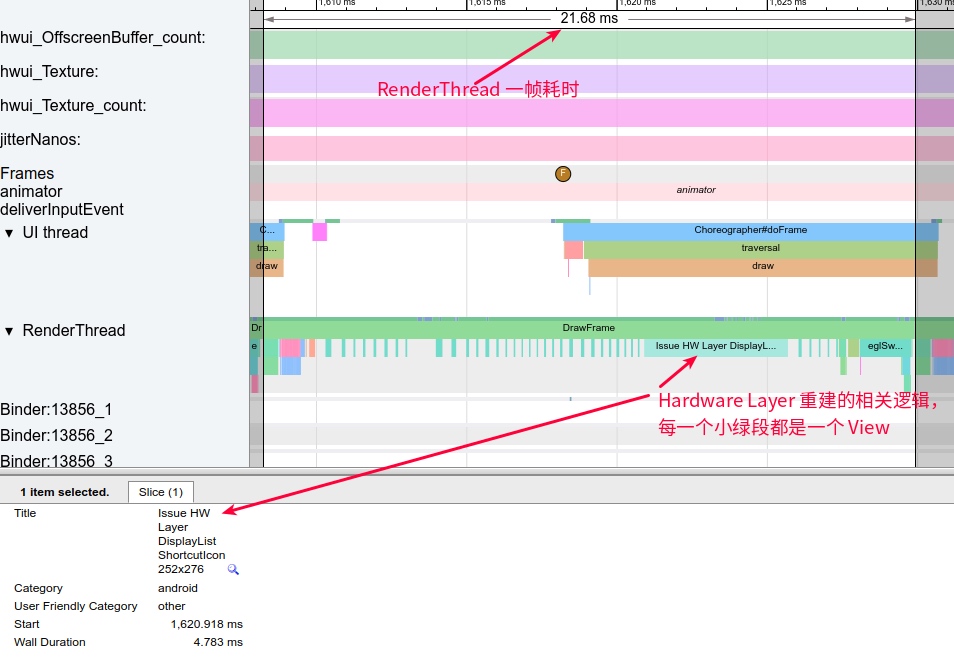
例如 Android 9 SkiaPipeline::createOrUpdateLayer 会检查 layer 是否存在、尺寸是否变化,允许复用现有资源;内容重绘与资源分配不是同一件事。
Debug 工具
部分历史系统的开发者选项提供“显示硬件层更新(Show hardware layers updates)”。入口和可用性因版本、厂商而异,不一定在“辅助功能”下面。
它标记更新的硬件 layer 区域,不是必然让整个界面变绿。稳定内容的变换动画通常希望初始化后复用;持续高亮说明要检查更新来源,但动态内容需要更新本来就是正常行为。没有高亮也不能单独证明缓存行为或性能。结合 Trace 中的 layer 绘制、尺寸和帧时序一起判断。
总结
- 先看内容是否稳定、绘制是否足够复杂,再决定是否给属性动画加 Hardware Layer。
- 不要“能加就加”。建立缓存、占用内存、绘制离屏内容再合成到窗口都有成本。
- Alpha 是否需要额外离屏工作与重叠内容、渲染路径等有关;不能把所有 setAlpha 或透明度动画都说成必然创建同一种 buffer。
- 内容 invalidate 可能导致重绘,但不等于必然重新分配整块资源。频繁变化时,应比较
NONE与 layer 路径,而不是预设固定优劣。 - 临时修改 layerType 后恢复原值;软件 layer 用于有明确兼容需求或收益的局部场景。
LayerType 对动画性能的影响示例
示例
代码
为了把前面讨论的情况放在一起比较,我写了个很小的例子,只用两个 TextView:一个开始动画,一个执行 TRANSLATION_X、ALPHA、TRANSLATION_Y、SCALE_X、SCALE_Y。Start/End 监听器选择 layer,Update 监听器控制是否修改文本。
示例项目的 固定源码快照(0060782a6c32337641acc14af3f9b4e8818402a3)在开始回调中连续设置 HARDWARE、SOFTWARE,最终生效的是 SOFTWARE,且文本更新已开启。直接运行这个快照不能得到六组独立对照。该工程配置为 compile/target SDK 29、min SDK 26,是历史工程。
下面保留原实验的 500 ms、150 px 平移、alpha 到 0、scaleX/scaleY 到 150 倍;这些不是常规 UI 参数。动态案例逐帧追加文本,会同时引入字符串分配、文本测量和布局变化,不能只归因于 layer。
代码是修正过语法的展示片段,不代表重新测得下方日志。每次只安装一个案例的一组监听器,替换下方默认监听器,不要把六组叠加;使用新的 AnimatorSet,并在开始前将 TextView 的 layer 设为 NONE,恢复文本、计数器、alpha=1、scaleX/scaleY=1、translationX/Y=0,等待布局完成,避免动画重入。只有在这个明确初始条件下,案例结束设回 NONE 才成立。项目字段、控件初始化和 imports 仍需来自完整工程。
1 | //设置动画 |
统计工具:GFXInfo
当时除了看 Systrace,我还用了 adb shell dumpsys gfxinfo <包名> 记录 HWUI 帧统计。下面是历史输出示意,图片里的旧解释需要按以下规则阅读:
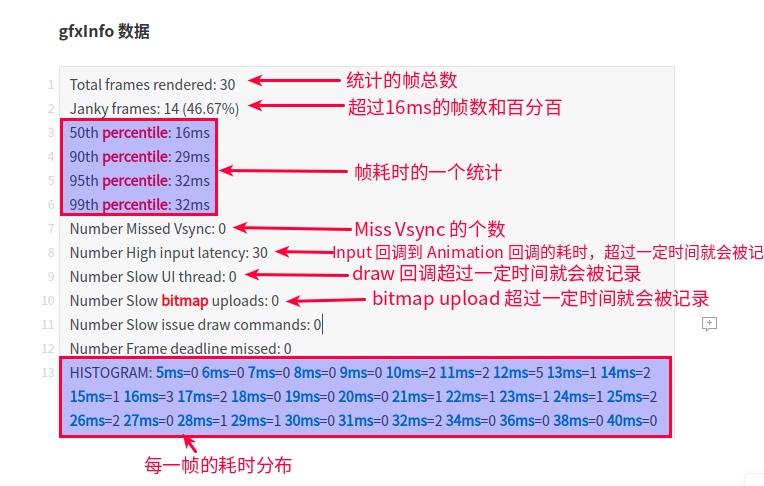
- Janky frames 按对应系统的帧间隔/截止时间规则统计,不是跨版本固定的“超过 16 ms”;直方图和 percentile 是分桶统计,99th percentile 不是精确最大值。
- High input latency 不是 CPU 负载,也不等于输入回调执行时长。Android 9 JankTracker 中存在三缓冲延后截止时间的分支;它可记录 high input latency 而不记录 missed deadline。各原因计数也不能简单相加当作 janky 总数。
- Android 16 JankTracker 同时保留 legacy 与更新的 deadline 统计路径。比较新设备时要保存系统版本、刷新率、统计区间和原始输出;gfxinfo 不覆盖完整输入到屏幕延迟。
- 六组旧日志每组只有 29–31 帧,设备、系统与采集重置条件记录不足。案例一和六连直方图都完全相同,不能当作已确认的独立测量。本次未在设备重跑,也未补造数据。
案例一:Normal Layer + 不动态更新 View 内容
代码
1 | // 不修改 layerType,也不更新文本。 |
Systrace 现象
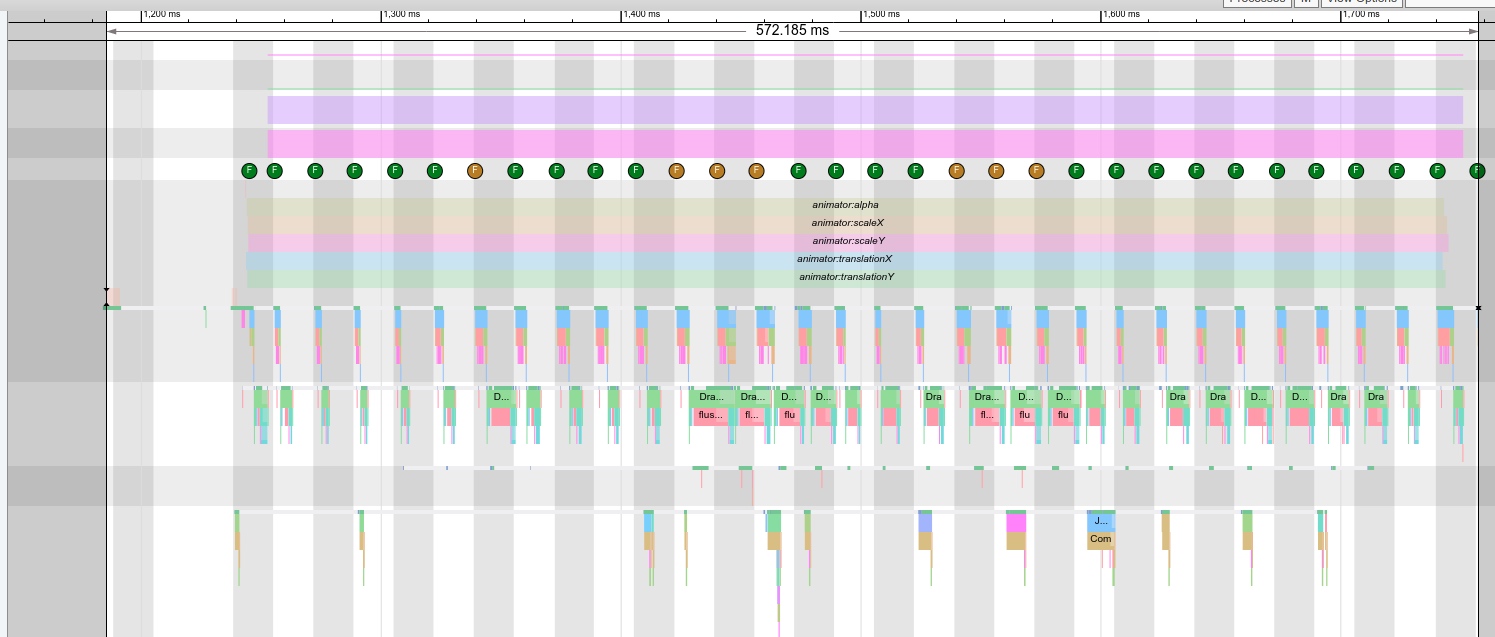
截图中有黄色帧标记,RenderThread 的 flush commands 片段较长;该片段仍是 CPU 侧工作或等待,不能直接读作 GPU 耗时。 下载历史 Trace
gfxInfo 数据
保留的日志记录 janky frames 为 14/30(46.67%),99th percentile 为 32 ms,High input latency 为 30。这是当次样本统计,不能据此判断主线程 CPU 负载。
1 | Total frames rendered: 30 |
案例二:Software Layer + 不动态更新 View 内容
代码
1 | objectAnimator1.addListener(new android.animation.AnimatorListenerAdapter() { |
Systrace 现象
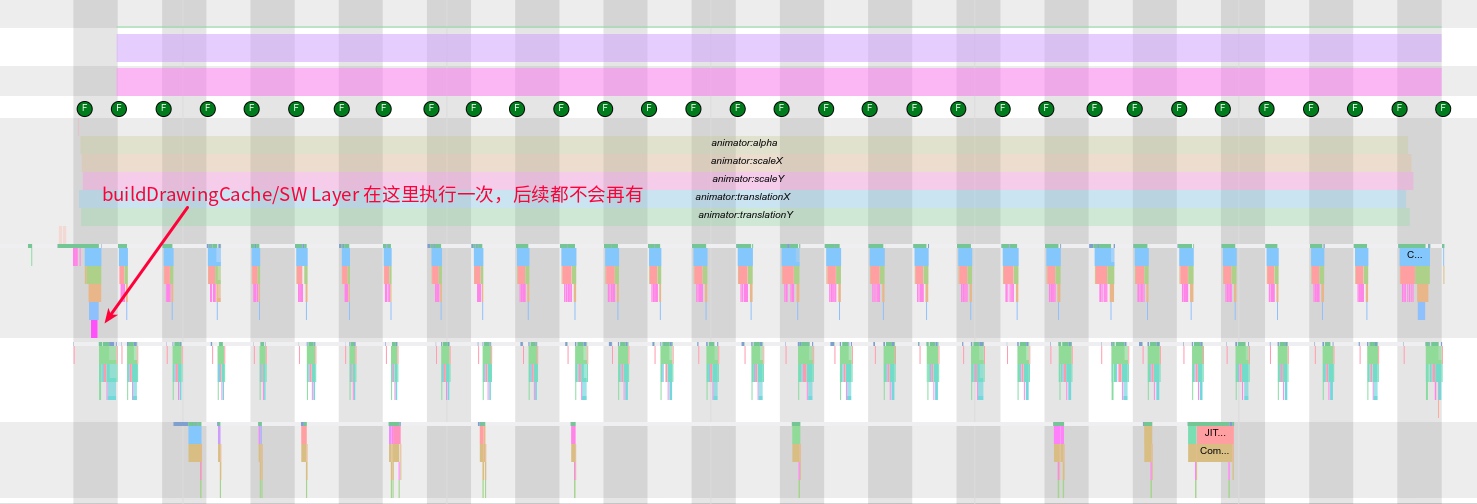
截图中先出现 buildDrawingCache/SW,后续展示的变换帧未见同样的缓存绘制,符合复用稳定内容的情况。绿色帧标记不能替代完整的帧时序和重复实验。 下载历史 Trace
gfxInfo 数据
保留的日志记录 janky frames 为 1/31(3.23%),99th percentile 为 16 ms,High input latency 为 0。
1 | Total frames rendered: 31 |
案例三:Hardware Layer + 不动态更新 View 内容
代码
1 | objectAnimator1.addListener(new android.animation.AnimatorListenerAdapter() { |
Systrace 现象
截图中出现初始 drawLayer,后续展示的帧为绿色。它支持检查缓存复用的方向,不能证明所有设备上的性能或完整输入延迟。 下载历史 Trace
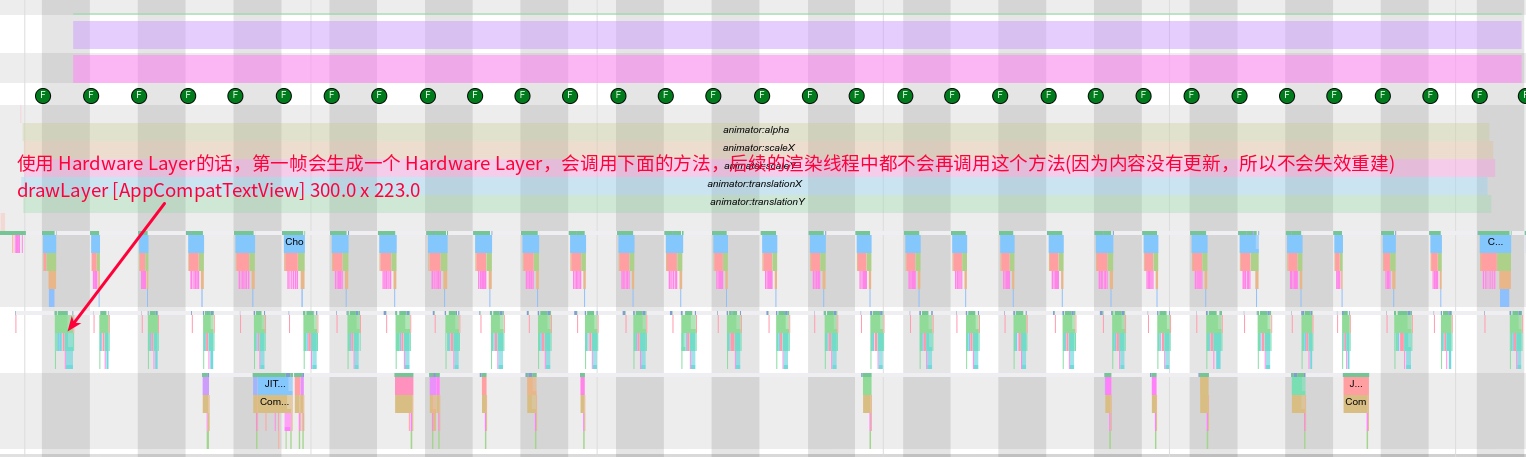
gfxInfo 数据
保留的日志记录 janky frames 为 0/31(0.00%),99th percentile 为 14 ms,High input latency 为 0。
1 | Total frames rendered: 31 |
案例四:Normal Layer + 动态更新 View 内容
代码
1 | objectAnimator1.addListener(new android.animation.AnimatorListenerAdapter() { |
Systrace 现象
动态追加文本时,Animation、measure、layout、draw 中有较长片段,需要区分文本更新开销、布局和调度等待。 下载历史 Trace
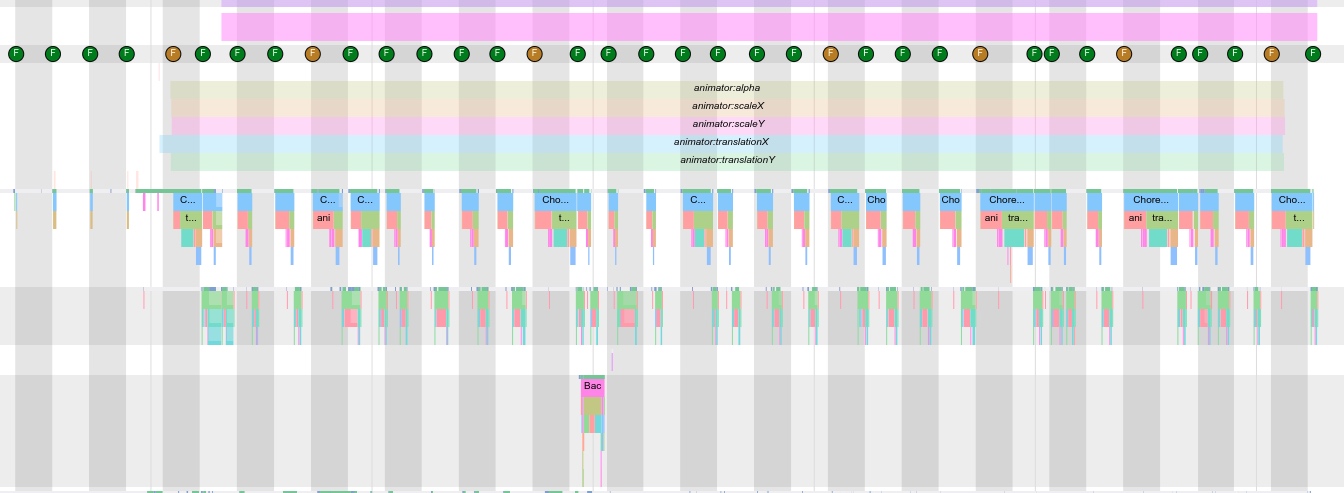
gfxInfo 数据
保留的日志记录 janky frames 为 12/31(38.71%),99th percentile 为 29 ms,High input latency 为 31。
1 | Total frames rendered: 31 |
案例五:Software Layer + 动态更新 View 内容
代码
1 | objectAnimator1.addListener(new android.animation.AnimatorListenerAdapter() { |
Systrace 现象
截图中反复出现 buildDrawingCache,说明软件缓存需要重绘;仅凭它不能断言每帧都销毁 Bitmap,也不能把所有耗时归到一个瓶颈。 下载历史 Trace
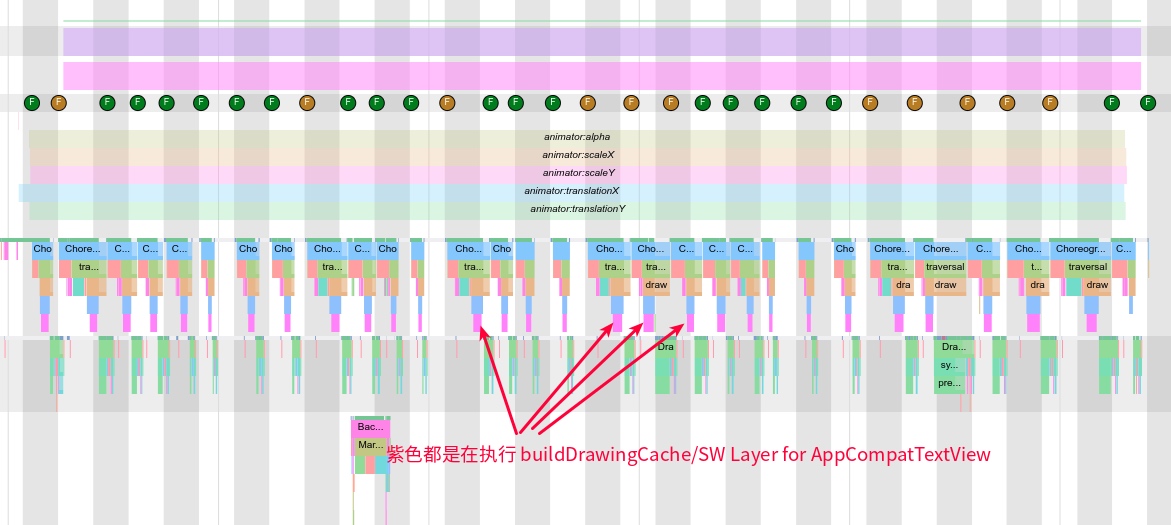
gfxInfo 数据
保留的日志记录 janky frames 为 12/29(41.38%),99th percentile 为 32 ms,High input latency 为 18。
1 | Total frames rendered: 29 |
案例六:Hardware Layer + 动态更新 View 内容
代码
1 | objectAnimator1.addListener(new android.animation.AnimatorListenerAdapter() { |
Systrace 现象
截图中反复出现 drawLayer;文本增长还会改变内容尺寸,图中 layer 尺寸与静态案例不同。尺寸变化可能要求重新分配,但这些 slice 不能证明每一帧都重新分配 buffer。 下载历史 Trace
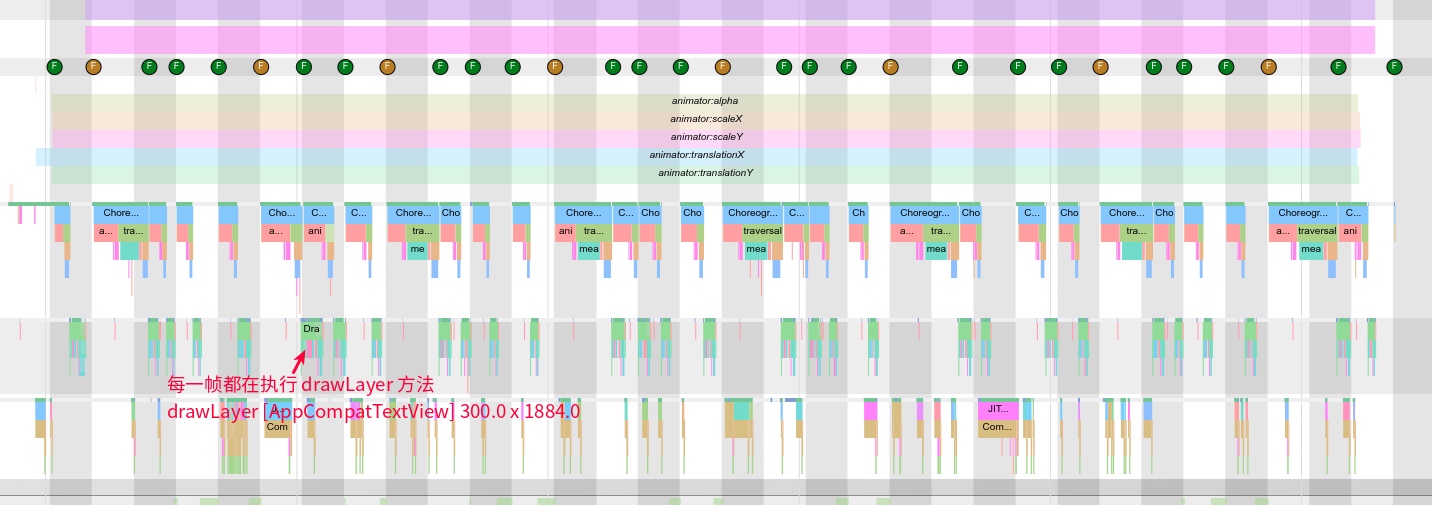
gfxInfo 数据
保留的日志记录 janky frames 为 14/30(46.67%),99th percentile 为 32 ms,High input latency 为 30。这是当次样本统计,不能据此判断主线程 CPU 负载。 这一整段与案例一完全重复,包括直方图。无法确认独立来源,不能用它做定量对照。
1 | Total frames rendered: 30 |
总结
六个案例保留了“内容稳定时缓存可能有用、内容变化时缓存需要更新”的观察方向,但不足以支持原来的固定性能排序。样本很小,案例一与六数据重复,动态文本还改变了工作量。
- 稳定且绘制复杂的 View,可比较临时 Hardware Layer 与 NONE 的帧时序、内存和 GPU 开销。
- 动态内容场景,先查为何失效、尺寸是否变化,再看 layer 的额外离屏成本,不预设 NONE 或某一种 layer 必胜。
- 重复 buildDrawingCache/drawLayer 是调查线索,不是“每帧重新分配”的证据,也不能单凭它归因系统或厂商。
- 新设备要固定版本、刷新率、初始状态和重复次数。Android 12(API 31)起还可结合 Perfetto FrameTimeline 观察 expected/actual frame;需要采到对应数据,缺失不代表没有卡顿。
现代实现可继续对照 Android 16 View、RenderNode、SkiaPipeline 与 ViewPropertyAnimator;源码标签用于说明实现边界,不代表本次在 Android 16 设备复现了旧实验。
既然读完了,如果有什么想法可以留言沟通,也可以扫文章下面的微信二维码加好友一起讨论;如有疏漏或者错误的地方,辛苦大家告知一下,我尽早更新以免误导他人;如果觉得有用,也请把这篇文章分享给其他人.
本文知乎地址
由于博客留言交流不方便,点赞或者交流,可以移步本文的知乎界面
知乎 - Android 中的 Hardware Layer 详解
关于我 && 博客
下面是个人的介绍和相关的链接,期望与同行的各位多多交流,三人行,则必有我师!
- 博主个人介绍 :里面有个人的微信和微信群链接。
- 本博客内容导航 :个人博客内容的一个导航。
- 个人整理和搜集的优秀博客文章 - Android 性能优化必知必会 :欢迎大家自荐和推荐 (微信私聊即可)
- Android性能优化知识星球:付费社群已于 2026 年停止运营,不再招收新成员;此处保留历史介绍。
一个人可以走的更快 , 一群人可以走的更远