

系统 Trace 能显示线程、CPU、帧和 Binder 等系统事件;播放器的 frame id、游戏 scene 名称或业务队列里的等待时间,需要应用自己提供。缺少这些标记时,一段主线程耗时只能定位到系统活动,难以对应业务阶段。
Perfetto SDK 的 Track Event 可以记录解码、纹理上传、队列深度和跨线程任务 ID。与系统轨道放在同一个时间窗口后,能先找到业务候选阶段,再用 RenderThread、GPU 和 FrameTimeline 验证它是否影响了可见帧。
接入前要先定事件名称、参数单位和采样频率。否则埋点虽然能显示在 UI 中,后续 SQL 仍无法稳定地按业务阶段聚合。
版本说明(2026-10 核查):本文 C++ SDK、类别优先级和触发器以 Perfetto v58.3 为核查基线;AndroidX
tracing-perfetto按 1.0.0 的职责说明。设备上的 tracing service、App SDK 和分析端 Trace Processor 可来自不同版本,需分别记录。示例参数供实验室起步使用,不代表所有 Android 设备或线上环境都支持。
Perfetto 系列文章
- Android Perfetto 系列目录
- Android Perfetto 系列 1:Perfetto 工具简介
- Android Perfetto 系列 2:Perfetto Trace 抓取
- Android Perfetto 系列 3:熟悉 Perfetto View
- Android Perfetto 系列 4:使用命令行在本地打开超大 Trace
- Android Perfetto 系列 5:Android App 基于 Choreographer 的渲染流程
- Android Perfetto 系列 6:为什么是 120Hz?高刷新率的优势与挑战
- Android Perfetto 系列 7:MainThread 和 RenderThread 解读
- Android Perfetto 系列 8:深入理解 Vsync 机制与性能分析
- Android Perfetto 系列 9:CPU 信息解读
- Android Perfetto 系列 10:Binder 调度与锁竞争
- Android Perfetto 系列 11:PerfettoSQL、Trace Processor 与回归检测
- Android Perfetto 系列 12:Trace 数据流与丢失排查
- Android Perfetto 系列 13:Perfetto SDK、Track Event 与 App 现场 Trace
- Android Perfetto 系列 14:heapprofd 与内存 Profiling
- Android Perfetto 系列 15:Boot Trace、长时间现场 Trace 与偶发问题抓取
- Android Perfetto 系列 16:GPU、Power Counters 与硬件瓶颈分析
- Android Perfetto 系列 17:专项场景自动化、问题清单与平台体系
- Android Perfetto 系列 18:响应速度实战,从输入事件到首帧反馈
- 视频(B站) - Android Perfetto 基础和案例分享
- 视频(B站) - Android Perfetto 分享 - 出图类型分享:AOSP、WebView、Flutter + OEM 系统优化分享
什么时候需要业务语义
没有业务语义缺口时,不需要接 SDK。先按场景选工具:
| 场景 | 建议 |
|---|---|
| Java/Kotlin 层临时标记函数耗时 | 用 android.os.Trace 或 AndroidX tracing,抓取时打开应用 atrace |
| Android native / C++ 模块要长期埋点 | 用 Perfetto SDK 的 Track Event |
| 跨平台引擎、游戏、播放器、Camera pipeline | 用 Track Event,加稳定参数和 counter |
| 要输出复杂结构化状态,普通 slice/counter 不够 | 再考虑自定义 DataSource |
| 只想知道系统线程状态、Binder、频率 | 先用系统数据源,没业务语义缺口时不用接 SDK |
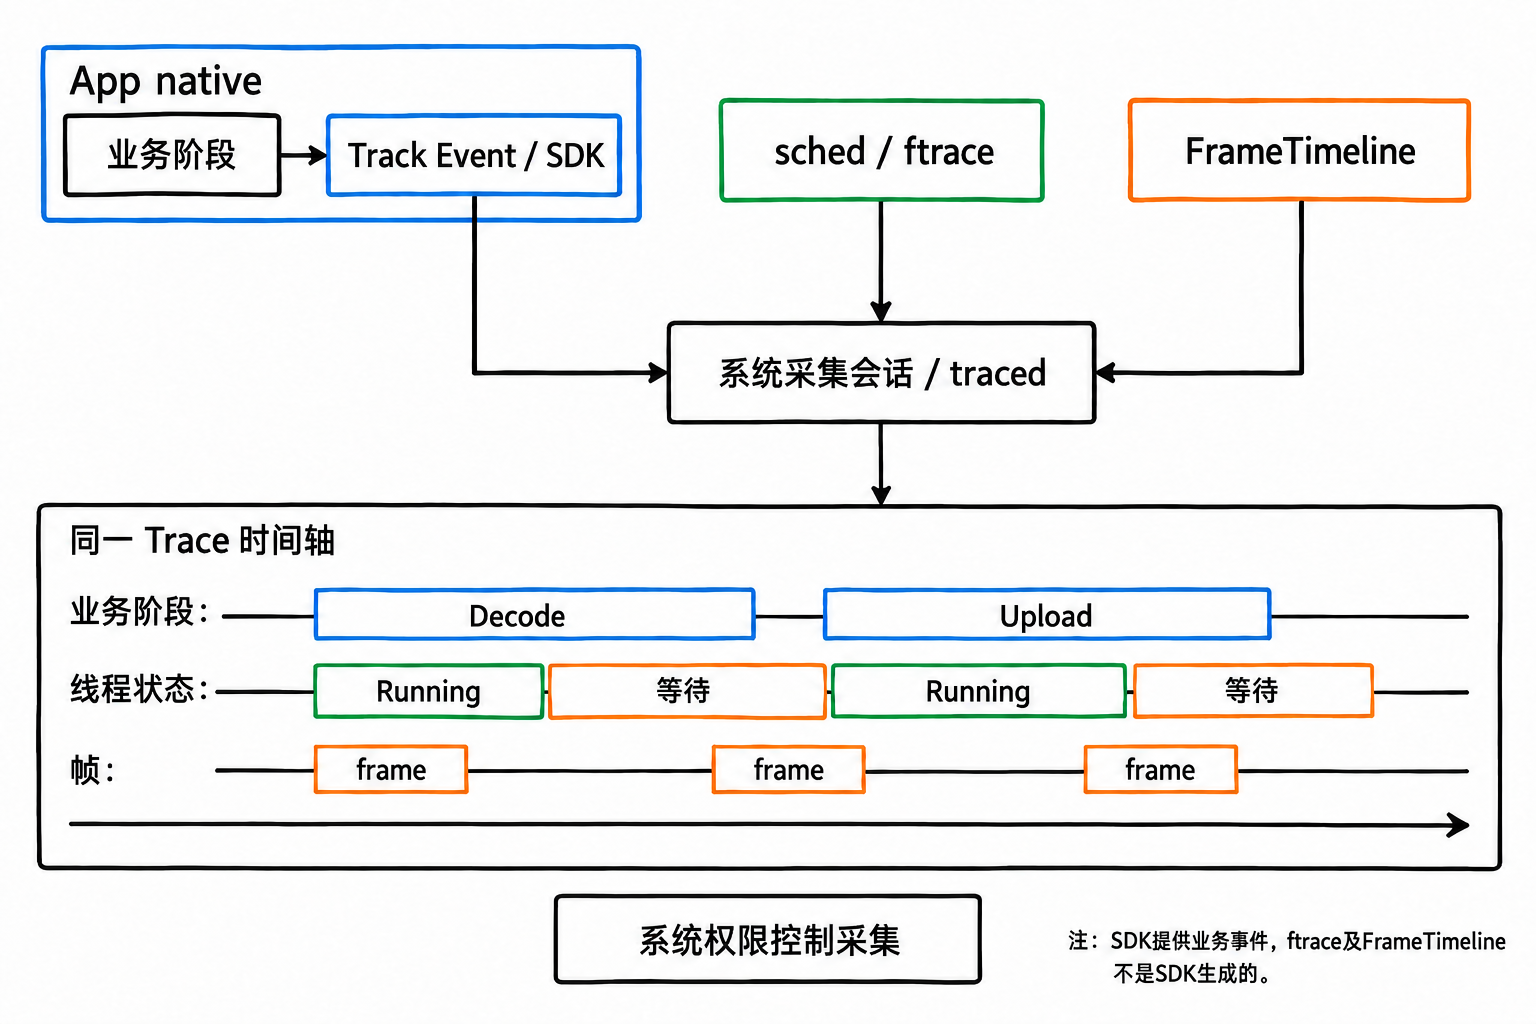
示意图:system backend 会话将 App 业务事件与独立系统数据源放在同一 Trace 中。
Android-only 场景里,如果 android.os.Trace 和 NDK ATrace_* 已经够用,官方也建议继续使用它们:这类事件会进入 Perfetto 的 atrace 路径,适合普通 App 函数标记,抓取时要在 linux.ftrace 里配置 atrace_apps: "com.example.app",或通过命令行 -a com.example.app 打开对应 App。SDK 仍然适合 Android 的 native、跨平台和结构化业务语义场景;简单 Android-only section 不必为了形式替换 ATrace。
Perfetto SDK 更适合 native 模块和跨平台模块。它直接产生 Track Event,支持 category、slice、counter、flow、参数、独立 track,也方便和系统 Trace 放在同一个时间轴上。本文示例使用 C++ SDK。上游仓库还包含 Java 接口源码 和 Rust SDK,不能再把“官方只有 C/C++”作为选型前提。不过 v58.3 的 src/android_sdk 中,PerfettoTrace 标有 @hide,并依赖 JNI 与平台相关注解;有源码不等于普通 App 已有稳定公开的 Java API 或可直接引入的发布包。Java/Kotlin 项目应先确认库的发布、native 链接和兼容合同;简单 section 继续用 android.os.Trace,需要 SDK 能力时再评估已有封装。
App 侧 tracing 能力先按边界选:
| 能力 | 典型用途 | 版本和现场边界 |
|---|---|---|
android.os.Trace / AndroidX Trace |
Java/Kotlin 粗粒度 section | 同步 section 从 API 18 提供;release App 的可采集条件需结合系统版本、debuggable/profileable 和采集工具核对,采集侧打开 atrace_apps |
NDK ATrace_* |
native 粗粒度 section | 同步 section 从 API 23、async/counter 从 API 29 提供;旧设备需 API 可用性保护 |
AndroidX tracing-perfetto |
向 Perfetto SDK 写入低开销事件,配合外部采集工具启用 | 1.0.0 支持预先配置后的启动期初始化;本身不授予 App 系统 trace 的读取权限 |
Perfetto SDK kSystemBackend |
native / 跨平台模块写 Track Event 到系统 Trace | Android 9 起平台集成 traced;仍需核对具体设备是否启用、producer socket 与 consumer 权限 |
ATrace 也有开销。热循环、每次锁尝试、每个对象都打 android.os.Trace / ATrace_*,会让 JNI、trace_marker 和内核路径本身扰动结果。Java/Kotlin 和 NDK ATrace 更适合粗粒度 section;高频业务状态优先用 SDK category gating、sampling,或者默认关闭的 debug category。
SDK 接入边界
Perfetto SDK 里有两层能力:
| 能力 | 适合表达 | 代价 |
|---|---|---|
| Track Event | 函数耗时、业务阶段、队列长度、frame id、请求 id、跨线程关系 | 接入成本低,Trace Processor 和 UI 原生支持 |
| Custom DataSource | 自定义 protobuf 状态、高频结构化数据、专用二进制格式 | 需要维护 schema,通常还要给 Trace Processor 补解析 |
只要 slice、counter、flow 和参数能表达问题,优先用 Track Event。自定义 DataSource 的门槛更高,不适合作为第一版埋点方案。
自定义 DataSource 适合两类情况:一类是普通 slice、counter 和 debug annotation 表达不了结构,比如要周期性转储一个子系统状态;另一类是数据量太大,需要强类型 schema 减少每条事件的体积。
自定义 protobuf 还要维护解析与查询接口。现有 slice、counter、flow 和参数能回答问题时,Track Event 的维护成本更低。
业务阶段字典先于代码
Track Event 不是把宏塞进每个函数。我更愿意先把业务阶段字典定下来,再写代码:事件叫什么、属于哪个阶段、字段单位是什么、缺字段时怎么降级,后续 SQL 和报告都要靠它。
event_name |
category |
phase |
必填参数 | 可选参数 | 单位/基数 | 采样 | 报告指标 |
|---|---|---|---|---|---|---|---|
DecodeFrame |
player |
decode | frame_id、stream_id、codec |
width、height |
frame_id 在 stream_id 内唯一 |
每帧一次,debug 字段按需开 | decode_dur_ms、decode_max_ms |
UploadTexture |
rendering |
upload | frame_id、texture_bytes |
surface_id |
texture_bytes 用 bytes |
每帧最多一次 | upload_dur_ms、upload_bytes |
RenderSubmit |
rendering |
submit | frame_id、surface_id |
queue_depth |
queue_depth 用 items |
每帧一次 | submit_dur_ms、queue_depth_items |
WaitForBuffer |
camera |
wait | request_id、buffer_queue |
producer |
request_id 在 session 内唯一 |
只在等待超过阈值时记录 | wait_for_buffer_ms |
字段改名、删字段、改单位,都要提升 arg_schema_version。长期报告字段不要叫 debug.frame_id,而应叫业务 schema 里的 frame_id / request_id,并记录 frame_id_domain、nullable_policy 和兼容策略。缺 RenderSubmit 时,报告只能输出 decode/upload 阶段,不能写端到端结论;字段里应写 missing_marker=RenderSubmit、evidence_grade=partial。
后文三阶段 SQL 还要求每个阶段携带同类型的 session_id/stream_id/frame_id,不能只给 DecodeFrame 写完整身份。WaitForBuffer 若等结束后才判断阈值,需要保存真实起止时间,并用正确时钟域回填;临时在结束处包一个 scope,测到的是打点耗时。
两种 backend 解决不同问题
Perfetto SDK 可以用 in-process backend,也可以用 system backend:
| Backend | 谁控制 Trace | 适合场景 |
|---|---|---|
kInProcessBackend |
App 自己创建 tracing session | 单进程验证、离线测试、只看业务事件 |
kSystemBackend |
外部 perfetto 命令或系统服务控制 |
和 sched、freq、Binder、FrameTimeline 合并分析 |
Android 性能分析里更常用 system backend。本例让 App 只做 producer,由有权限的外部 consumer 控制系统 tracing session。连接 producer socket 不等于有权限读取系统 Trace;普通 App 不能据此获取其他进程的数据。SDK 本身也有 consumer API,能否使用 system backend 的读取能力取决于平台权限,不能把角色约束误写成 API 不存在。
以下系统采集示例以 Android 12+ 的 FrameTimeline 数据源为前提,仍需核对设备支持情况;SDK 的 system backend 并非从 Android 12 才出现。线上接入还要单独评估包体、初始化开销和开关策略。
最小接入骨架
最小接入只解决三件事:稳定 category、system backend、可查询事件名。native 模块接入骨架如下。
1 | // tracing_categories.h |
头文件只声明 category。category 名会进入 Trace 和后续 SQL,名字要稳定,不要把动态 id、页面实例号或请求号塞进 category 名里。
1 | // tracing_categories.cc |
PERFETTO_TRACK_EVENT_STATIC_STORAGE() 给 Track Event 注册需要的静态存储留位置。它只应该出现在一个 .cc 文件里,避免多重定义。
1 | // tracing_init.cc |
初始化阶段选择 backend,并把前面定义的 category 注册给 Track Event。Android 系统 Trace 场景里通常用 kSystemBackend,这样 App 事件才能和系统 sched、Binder、FrameTimeline 放在同一份 Trace 里。
之后就能在业务代码里打点。这段用 slice 表示耗时,用参数记录 frame id:
1 | void DecodeFrame(int frame_id) { |
TRACE_EVENT 是作用域事件。进入当前作用域时开始,离开当前作用域时结束。它适合包住一段同步工作,例如 decode、layout、upload、submit。
不跟随函数作用域的事件,用 TRACE_EVENT_BEGIN 和 TRACE_EVENT_END。这对跨多个函数的阶段有用,但不要把 begin/end 分散到完全不相关的调用路径里,容易造成同线程 slice 嵌套混乱、闭合错配或 SQL 解释困难。
接 SDK 时还要留一个构建层面的边界。官方 C++ SDK 是 C++17 库,发布包里常见形态是 perfetto.h 和 perfetto.cc 两个合并版源文件,适合塞进已有 native 构建系统。
只放进 perfetto.h 还不够:要确认编译标准、线程库、符号裁剪、包体增量,以及 App 进程启动早期是否已经完成 Tracing::Initialize()。
perfetto.h 与 perfetto.cc 要取自同一 SDK 发布包,并把后者编译链接进目标;不要混用不同版本的头文件与实现。上面的 std::call_once 只保护本模块入口,整个进程内的其他库也应共用初始化策略。
普通初始化路径中,Track Event 要等数据源启用才开始记录。v58.3 另有 SetupStartupTracingBlocking 这一显式 startup-tracing API,不能把它当作普通 Initialize 的默认行为。AndroidX tracing-perfetto 1.0.0 可在外部工具预先配置后,于 App 启动时初始化埋点;它不独自采集 zygote、ActivityTaskManager 或首帧呈现。冷启动分析仍需同时开启对应系统数据源。
初始化时机和进程边界要一起定。Tracing::Initialize() 全进程只做一次,放在进程入口的确定路径上(比如 JNI_OnLoad 或 Application#onCreate 触发的 so 加载),并做好幂等保护;注册之前发出的 Track Event 会被静默丢弃,不报错,事后很难和真丢包区分。多进程 App 的每个进程都要各自 Initialize + Register,:remote、:player 这类子进程不会继承主进程的初始化。system backend 下,进程在 tracing session 已经开始后才启动也没关系:producer 连上 traced 之后,符合配置的数据源会被自动启用,只是连接之前的事件不存在,分析时不要把这段空白当成业务空闲。
category 是线上开关
category 决定哪些事件会被打开。建议把它当成配置接口设计,不要随手起名。C++ SDK(perfetto::Category)里没有命中任何规则时,非 debug、非 slow category 默认会被打开;C SDK(PerfettoTeCategory)的默认行为相反,未命中规则的 category 默认关闭。
线上 preset 的主规则很简单:显式 disabled_categories: "*",再白名单打开需要的 category。这样可以避开 C/C++ 默认差异,也能避免 debug category 在现场意外打开。debug 和 slow tag 默认关闭,专项分析时再显式打开。
规则有优先级:精确 enabled category 先于 disabled tag 判断,因此显式放行一个带 debug tag 的类别,仍会把它打开。这个 allowlist 是事件开关控制,不是不可绕过的安全边界。
常见划分方式:
player:播放器主阶段,例如 prepare、decode、render。rendering:渲染提交、纹理上传、场景切换。camera:request、HAL callback、buffer queue。pipeline.debug:调试用高频事件,定义 category 时加debugtag。pipeline.slow:开销较高的事件,定义 category 时加slowtag。
category 应按子系统和开关粒度设计,不按页面、实验组、请求类型命名;页面、实验组、请求类型放参数或 metadata,避免 category 数量膨胀。
以下配置明确选择 category:
1 | buffers { |
这样做的好处是,现场抓 Trace 时不必换包,只改配置就能决定打开哪些业务事件。system backend 下 track_event 可能来自多个 producer,现场或线上 preset 要用 producer_name_filter / regex 把范围收住。示例里的 com.example.app 只是占位;先从 trace、data source 或 producer 列表确认实际 producer name,多进程 App 用多个 exact filter 或 regex filter。
和系统 Trace 一起抓
业务事件只解释“业务正在做什么”。系统事件解释“这段业务为什么慢”。合抓时,一般把 track_event 和 ftrace 放在同一份配置里:
1 | buffers { size_kb: 16384 fill_policy: RING_BUFFER } # 0: sched / ftrace |
这里两个 central buffer 合计 20 MiB;原示例 160 MiB 会超出 v58.3 启用 extra guardrails 时默认的 128 MiB 总量限制。20 MiB 也不保证留存 10 秒,应按写入速率和 stats 调整,per-CPU ftrace buffer 另算。把这段完整配置保存为 app-sdk.pbtxt,替换 App 包名和实际 producer 名称后,在授权测试设备上执行:
1 | adb shell perfetto --query |
第二条命令前台运行 10 秒,期间在设备上触发待测业务;确认采集成功后再 pull。--query 用于核对当前注册的数据源和 producer,目标进程还未启动时不一定出现在列表中。系统版本缺少数据源、权限被拒或同路径已有旧文件时,不能把 pull 到文件当成采集成功。
抓完后,用 SQL 确认事件进来了。这条 SQL 用第 11 篇讲过的 thread_slice 视图,直接把进程名、线程名和业务参数查出来。thread_slice 是 slices.with_context 提供的视图,已经把 slice、track、thread、process 关联好;单篇阅读时只要保留前面的 INCLUDE 即可。
1 | INCLUDE PERFETTO MODULE slices.with_context; |
这条查询适合默认线程 track 上的 Track Event 或 atrace slice。独立 track、process track 事件不一定有 utid,可能不会出现在 thread_slice 里;这类事件要改用 process_slice、thread_or_process_slice,或直接从 slice JOIN track 查,再按 track.name/parent_id 还原上下文。
这条 SQL 的价值不止是“查到了事件”,它还能继续和 thread_state、CPU 频率、Binder 事件、FrameTimeline 做时间范围关联。TrackEvent slice 是业务时间轴证据,不等于 CPU 一直在执行这段业务;CPU 执行要再关联 sched / thread_state,并区分默认 ThreadTrack、自定义 Track 和跨线程 flow。普通 key/value 参数会作为 debug annotation 进入 args,SQL 用 debug.<key> 读取;typed TrackEvent 字段不走这个 debug.* args 口径,需要对应解析、表或专用字段。
时间范围关联只是第一步。App 的 frame_id 是业务帧,FrameTimeline 的 frame/vsync 是系统帧;只靠时间重叠容易把排队、预渲染、跨线程工作归到错误帧。最终要结合 Choreographer frame/vsync、JankStats frame start、RenderThread/HWUI slice、actual_frame_timeline_slice / expected_frame_timeline_slice 再确认。
这里的 frame_id 是 debug annotation,适合排查和临时 SQL。debug annotation 默认是调试字段;如果进入长期指标,要把字段名、类型、单位、缺省值和迁移策略当成接口冻结。只有能控制 Perfetto proto、解析和发布流程时,再考虑 typed TrackEvent 字段或自定义 DataSource。现场 preset 可用 filter_debug_annotations / filter_dynamic_event_names 减少部分内容,但不是完整脱敏;前者也会移除这里 SQL 依赖的 ID,报告必须按 missing_identity 降级。
业务阶段报告必须按进程、session、stream、frame 组合键检查三个必需 marker,不能只看见 RenderSubmit 就标完整。以下查询要求三个阶段都写入 session_id/stream_id/frame_id;前面的最小单点示例只有 frame_id,需要先补齐参数。缺身份字段的事件应单列为 missing_identity,不要与其他空 ID 事件合并。
1 | INCLUDE PERFETTO MODULE slices.with_context; |
这里的 complete 只表示业务 marker 数量和闭合状态符合本例契约,不证明帧已经显示。下面是另加 FrameTimeline 关联和缺项展开后的报告示意,并非上述 SQL 的直接输出:
这也不检查阶段时序、采样覆盖或版本混用;整个 frame 都没打点时,本查询不会产生一行“缺失帧”。要统计漏帧或端到端覆盖率,还需要独立的预期帧清单与身份映射。
1 | trace_name,scenario,frame_or_request_id,phase,start_ms,dur_ms,thread_name,frame_jank_type,evidence_grade,missing_marker |
跨线程任务用 flow 或独立 track
很多业务慢不在单个函数里,而在队列之间。比如 UI 线程提交一个请求,decoder 线程处理,render 线程消费。只用同线程 slice,读者很难看出它们属于同一个 frame。
可以用 flow 把相关事件连起来。下面在入队前分配 token,把同一个 FrameToken 随任务传给后续线程;不要在每个阶段重新分配,也不要把容易复用的 frame_id 或哈希直接当作唯一 ID。这里只展示埋点封装,实际队列负责传递 token;三个 callable 分别包住真实的入队、解码和消费工作。分配器应全进程唯一,不能在每个 so 中各放一份,且不得回绕复用:
1 |
|
选中事件时,Perfetto UI 会用箭头展示关系。中间阶段继续使用 Flow,最终消费阶段再用 TerminatingFlow。
这里用的是 ProcessScoped(flow_id),所以 id 至少要在进程内、一次 Trace 生命周期内稳定,不要直接拿容易复用的临时指针当 flow id;跨进程 flow 不要继续用 ProcessScoped 语义,至少要使用全局唯一 id,并明确 namespace 和来源进程。多阶段 pipeline 也可以给每条边单独分配 flow id,例如 enqueue_to_decode_flow_id、decode_to_render_flow_id,避免一条 flow 被多条路径复用。
如果一个任务跨函数、跨线程持续很久,也可以放到独立 track 上:
1 | void StartRequest(uint64_t request_id) { |
这类事件适合任务队列、播放器 pipeline、异步加载、跨线程 GPU 提交。它比“每个函数都打点”更能解释业务路径。
同一 track 上的 begin/end 仍按栈闭合;并发且非嵌套的任务要使用不同 track,取消和异常路径也要配对结束。v58.3 的 Track(id) 默认以进程 track 为父级并派生 UUID,id=0 会与父级冲突;专用 ID 仍需在该命名空间内唯一。
高基数任务结束且不再写入后,可用 TrackEvent::EraseTrackDescriptor(track) 清理 SDK 内的自定义 descriptor,避免长期运行时注册表持续增长;这不会删掉已经写入 trace 的历史事件。
perfetto::Track(request_id) 里的 id 要在一次 Trace 内对这个并发任务唯一。线上 request id、frame id 很容易复用,复用后不同任务会合到同一条 track,看起来像一个长任务或错误串行。更稳的做法是加 session/pipeline namespace,或者生成专用 64-bit track id;需要长期阅读时,补 track descriptor / name,让 UI 和 SQL 都能识别生命周期。descriptor / interning 丢失时,要回到第 12 篇的 stats 检查。
Counter 只放状态,不放日志
counter 适合随时间变化的数值,例如队列长度、in-flight 请求数、buffer 占用。frame id 是标识符,不是可聚合指标;它更适合放在 slice 参数或 flow id 里。这个例子记录 decode 队列深度:
1 | void ReportDecodeQueueDepth(int depth) { |
counter 不适合承载日志文本,也不适合拿标识符做 avg/max。日志放 logcat,Trace 里只保留能和时间轴关联、可以被解释为状态的数值。
counter 要固定单位和聚合口径。上例实际 track 名是 DecodeQueueDepth,items 是 unit_name,并不会自动拼到名字上。队列深度的窗口均值应按状态保持的时长加权,不能直接平均稀疏样本;窗口前没有已知初始值的部分保持 unknown。InFlightRequests 看峰值和持续时间,BufferBytes 看峰值、增长斜率和是否回落;标识符不能求 avg/max。
事件名是 SQL 接口
事件名一旦进了 SQL、看板和回归报告,就变成了接口。不要把动态 id 拼进事件名。
1 | // 不建议:每个 frame 都会生成不同事件名,SQL 很难稳定统计。 |
更好的命名方式是“阶段 + 动作”:
DecodeFrame:解码一个业务帧,参数带frame_id、stream_id、codec。UploadTexture:上传纹理或 buffer,参数带frame_id、texture_bytes。RenderScene:提交一轮场景渲染,参数带scene_id或surface_id。SubmitRequest:提交一个跨线程请求,参数带request_id和queue_depth。WaitForBuffer:等待上游 buffer,可和 Binder、线程状态、buffer queue 证据关联。
事件名稳定以后,后面的 SQL 才能稳定。耗时列统一用 / 1e6 换算:time.conversion 的 time_to_ms() 是整数除法,会把最大耗时截断成整毫秒,和平均值不在一个精度上:
下面按 upid/utid 分组,避免同名进程重启或同名线程混到一起;统计范围是整份 trace 内已闭合的匹配 slice,不代表某次操作或总体帧分布。专项窗口需另加时间与身份筛选,并单独报告未闭合记录。
1 | INCLUDE PERFETTO MODULE slices.with_context; |
控制写入量
Track Event 开销低,但不是免费。常规 ATrace 路径会压 ftrace per-CPU buffer;SDK Track Event 主要压 producer shared memory、central buffer 和 incremental state。v58.3 还有 atrace_categories_prefer_sdk 等改路能力,不能只凭 API 名判断链路;按实际 data source 和 stats 定位瓶颈。
建议给每类埋点设一个预算:
- 事件密度:按
events/sec、每帧事件数、参数字节数和目标 Trace 时长估算写入量。120Hz、多线程、多阶段和动态字符串叠加后,每帧一次也可能过密。 - 数据形状:每个小对象、每次锁尝试、每个像素级循环都不适合默认开启;高频 debug category 默认关闭,专项 Trace 可用 1/N 采样或触发后短窗口开启。
- 参数开销:便宜标量可直接传;昂贵字符串、JSON、容器遍历、锁内状态快照放在 enabled 判断或 lambda 内。参数在宏调用前已经拼好时,category gating 救不了这部分开销。
- producer 侧兜底:确认瓶颈来自 shared memory 突发时,再评估
shmem_size_hint_kb和BufferExhaustedPolicy::kStall,两者的取舍第 12 篇已经展开;默认先降事件密度、拆大包,不要一上来就调参数。 - 采集验收:长 Trace 里把业务 Track Event 放到独立 central buffer,抓完用下面的验收查询过一遍
traced_buf_*和track_event_*统计项;分 buffer 只能隔离 central buffer 竞争,不能修复 producer shared memory burst loss。 - Ring Buffer 场景要关注 Track Event 的 descriptor / string interning / incremental state,可让同一 packet sequence 上的元数据随增量状态重建而重发,并降低同 buffer 的写入竞争。
clear_period_ms只是请求支持该能力的 producer 周期重建;它不能恢复已丢事件,也不能把相关元数据随意拆到另一序列。
统一验收查询可以先从第 12 篇的 health check 开始,再补 Track Event 专用项:
1 | SELECT name, idx, severity, source, value |
报告里单独给 track_event_trust_level。即使已提供的 packet loss 统计为 0,非零 track_event_tokenizer_errors 或 track_hierarchy_missing_uuid 仍需定位,受影响的业务事件不能直接作为完整证据。
验收时先区分统计项存在且值为 0、统计项未提供、解析失败。上述非零查询返回空集不等于所有检查都通过;错误还需定位到受影响的 sequence/track/时间窗,避免把局部问题扩大成整份 Trace 不可用。
App 侧现场 Trace 协议
App 侧接 Perfetto,最容易踩的坑是把 App 当成一个小型 adb shell perfetto 客户端。普通 App 没有随意启动系统 tracing 的权限,也不适合在线上动态下发高开销 TraceConfig。现场方案更适合拆成三层:
- 平台侧:预置受控 TraceConfig,声明 trigger、Ring Buffer、文件路径、数据源白名单和采集上限。
- App 侧:记录业务埋点和页面状态,检测慢帧、卡死、超时等异常,按平台约定激活 trigger。
- 服务端:接收 Trace package,跑
stats、摘要 SQL 和聚合索引,给人工分析留出可复查入口。
Perfetto 的 STOP trigger 很适合这类场景:trace 先以 Ring Buffer 方式循环记录,App 检测到问题后触发一个已声明的名字,系统在 stop_delay_ms 之后收尾。这样能保留问题发生前的一段现场,也能把触发后的尾巴收进来。
一个受控现场 UI 卡顿 preset 可以长这样。它适合灰度白名单、采样率受控、写入速率已实测、stats 可验收的实验室或现场排查;线上默认 preset 应减少 atrace category,必要时只保留 sched、FrameTimeline 和最小 Track Event。它不是“全量图形专项 preset”,但足够支持主线程、RenderThread/HWUI、FrameTimeline、CPU 调度、SurfaceFlinger 侧 FrameTimeline/线程调度线索和 App Track Event 的第一轮定位;涉及 Layer、Transaction、HWC、Display 归因时,切换图形专项 preset。
1 | buffers { size_kb: 16384 fill_policy: RING_BUFFER } # 0: sched / ftrace |
这里 skip_probability: 0.8 表示先以 80% 概率跳过,再检查滚动 24 小时次数限制。实验室验证应另存一份 preset,把 skip_probability 设为 0,并使用未耗尽配额的测试 trigger。未被接受的触发不产生预期结果;30 分钟内没有接受到 trigger,STOP_TRACING 会结束且不返回数据。30 分钟是等待期限,不保证 Ring Buffer 保留了 30 分钟历史。产品仍要做平台侧权限、采样与配额管理。
实验室先把上面 trigger 配置保存为单独的 app-trigger.pbtxt,按上文命令启动该配置,另一个终端再发送 trigger;原 10 秒配置没有声明 trigger,不能拿它验证。STOP 会结束这次 session,持续监测需要平台另行启动下一次 session。确认实验室采样与配额后,命令为:
1 | adb shell /system/bin/trigger_perfetto app_ui_jank |
Perfetto trigger 的模型是:有权限的 consumer 预先声明 trigger 名字,App 这类 producer 只能激活已声明的名字。接了 Perfetto SDK 的 native 模块也可以用 SDK 触发;产品上仍建议由平台接口统一控制权限和配额:
1 | perfetto::Tracing::ActivateTriggers({"app_ui_jank"}, 10000); |
第二个参数单位为 ms:调用立即返回,向当前已连接及未来 10000 ms 内连接的已初始化 backend 发信号;它不是阻塞等待时长,也不是采集后的 1 秒尾窗。返回不证明请求被接受或 trace 已生成。未配置 producer_name_regex 时,任何已连接 producer 都能激活匹配名称;名称与 producer 过滤都不应被当作业务授权凭证。
线上 App 不应假设自己能执行 /system/bin/trigger_perfetto。更推荐由平台提供受控接口,例如系统服务、厂商 SDK、企业版设备管理组件或测试框架代理。App 只提交一个受限请求:
1 | { |
平台侧根据 preset 白名单、采样率、权限、设备状态和每日配额决定是否触发。这套接口约定比“App 自己拼 TraceConfig”更适合长期维护。服务端匹配时应输出 trigger_event_ts、nearest_marker、marker_delta_ms、matched_by,避免外部 JSON 和 trace 时间轴只靠人工猜。
触发策略要靠近用户感知,而不是靠近内部实现细节:
| 触发 | 典型信号 | Trace 里要看什么 |
|---|---|---|
| UI 慢帧 | JankStats 连续慢帧、严重超预算 | 主线程、RenderThread、FrameTimeline、CPU |
| 主线程卡死前兆 | 2s / 4s / 8s watchdog | 主线程状态、Binder、锁、IO、系统服务 |
| 业务 timeout | Camera open、播放器 prepare、首屏 timeout | App marker、Binder、HAL、线程状态 |
触发名进入平台 preset 后要保持稳定。改名会让服务端聚合、SQL 模板和历史数据断开。
Trace package 要带上下文
一份现场包先分最小必需和平台化扩展。本篇只要求最小必需:Trace 本体、业务 metadata、采集 preset、stats 可信度结果。上传策略、日志白名单和保留周期属于平台化后的规则,可以后续单独设计。
1 | trace-package/ |
app_metadata.json 描述这次问题现场,字段要固定并带 schema 版本:
以下 JSON 都是假设数据。trigger 请求中的 jank_frames 只展示三帧中的一帧,真实请求应提供完整依据或明确摘要;8.333333 ms 仅为固定 120 Hz 的周期示意,不直接等于 JankStats 阈值或可变刷新率下的帧 deadline。未知刷新率和温度状态保留 null/unknown,不能默认填 120/normal。
1 | { |
其他几个文件也要有最小字段:
trace_stats.json 至少保留第 12 篇 health check 的结果:
覆盖 chunk 的计数不等于丢失事件数,也不能单独证明目标帧受损。下面 idx=1 对应本 preset 中 Track Event 与 FrameTimeline 共用的 buffer;先检查目标时间窗、闭合状态和解析错误,再决定哪些指标可用,不能直接降级全部 App marker。
1 | { |
upload_policy.json 说明这份现场包能不能上传、保留多久:
1 | { |
app_events.jsonl 用一行一个 JSON 事件保存触发点和少量 App 侧状态,并和 Track Event 共享 scenario_id/session_id/action_id:
1 | {"elapsed_realtime_ns":123456789000000,"event":"trigger","scenario_id":"feed_scroll_120hz","session_id":"s-20260504-001","action_id":"scroll-42","page":"Feed","action":"scroll"} |
log_excerpt.txt 只放白名单 tag 的短窗口摘要,至少记录 tag、level、elapsed realtime 和脱敏后的 message。
时间戳应记录真实 clock domain、单位与同一次开机的关联标识。Android 的 elapsedRealtimeNanos 对应包含休眠时间的 CLOCK_BOOTTIME;JankStats 的 frameStartNanos 基于 uptime/System.nanoTime 时间域,不能直接改名为 elapsed_realtime。需要同一现场的时钟配对或 ClockSnapshot 转换;跨休眠时不能套用一个旧的固定 offset。Perfetto 只会处理 trace 内的时钟映射,外部 JSON 不会自动归一,单独记 trace start/end 也不足以求出不同时间域的关系。Track Event 默认让 SDK 取时间;只有转换有据可查时才回填显式 timestamp。
App 侧不要直接截断 trace.perfetto-trace。Perfetto Trace 是 protobuf 流,粗暴二进制裁剪可能破坏 packet、时钟同步和增量状态。更稳的做法是在采集侧控制窗口:Ring Buffer 控制触发前窗口,stop_delay_ms 控制触发后窗口,trigger 限频控制重复抓取。
max_file_size_bytes 是文件大小硬上限,达到后会停止 tracing;长时间 flight recorder 如果 cap 太小,可能在 trigger 前就结束。它适合和 write_into_file / file_write_period_ms 一起控制落盘风险,不是窗口裁剪工具。
平台化后,上传策略再把配额、隐私和重试写进产品规则:
- 设备侧配额:按用户、设备、版本、trigger 和天维度限频。
- 网络条件:默认只在 Wi-Fi 或用户允许的网络上传,低电量、温度异常、后台受限时延后。
- 内容白名单:metadata 字段固定,log 只允许白名单 tag,App trace section 禁止拼接用户输入。
- Trace 本体:最小化数据源,限制进程/producer,避免默认 logcat;ftrace、sched、Binder、线程名、进程名本身也可能是敏感信息。
- 传输和保留:加密上传,服务端访问审计,Trace、log 摘要、聚合结果设置独立 TTL,到期自动清理。
App 记录业务阶段和异常触发;平台控制采集配置、文件大小与上传;服务端检查数据质量并保存可追溯的摘要。现场问题复现后,先核对这些记录是否覆盖同一操作窗口,再谈跨设备聚合。
总结
Track Event 补上系统 Trace 缺少的业务标识。它能说明某个阶段何时运行、队列多深、请求如何跨线程移动;能否解释最终卡顿,还要与系统轨道和帧时间线对齐。
工程上建议按这个顺序做:Java/Kotlin 层先用 android.os.Trace,native 长期埋点用 Track Event,复杂结构再考虑自定义 DataSource。事件名稳定、category 可控、counter 有单位、flow 有稳定 id,后面的 SQL 和报告才可长期复用。进入现场 Trace 后,App 还要把触发、metadata、证据包和上传策略一起设计好。
参考文档
- Tracing SDK
- Track events
- Recording In-App Traces with Perfetto
- androidx.tracing.perfetto
- Trace configuration - Triggers
- android.os.Trace
- JankStats Library
本次核对:v58.3 SDK、类别优先级、Track/CounterTrack、触发器 API 与 TraceConfig。AndroidX 另参考 Tracing 1.0.0 发布记录、FrameData 和 SystemClock 和 NDK ATrace API。以下保留原文 2026-09-19 的源码入口供对照。
关于我 && 博客
欢迎关注 Android Performance。